Modelo pequeño y una tarea real en el ordenador disponible.
Guía fundacional
Superordenador personal y mini PC para IA: qué es y cómo elegir
La categoría reúne equipos de sobremesa concebidos para modelos locales, ajuste, RAG y agentes. Su rasgo decisivo suele ser la combinación de memoria amplia, aceleración de IA, interconexión y software, no una única cifra de cómputo.
IA junto al usuarioMemoria como requisito centralDesarrollo y despliegue local
Ruta para pymes
Una pyme no debería empezar comprando: debería empezar midiendo
Prueba primero la tarea en el equipo disponible. Compra un sistema dedicado cuando necesites más memoria, servicio continuo, separación de los puestos o varias personas trabajando a la vez.
ASUS o Lenovo de 1 TB como entrada GB10; Spark de 4 TB para más biblioteca local.
GPU de servidor, parejas y clústeres.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Ruta de montaje
Lo que conviene tener a mano (y cómo sabrás que vas bien)
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
Una carga real definida: modelo, contexto, número de usuarios y tiempo objetivo.
Poder traducir la carga a memoria, aceleración y tipo de plataforma sin comprar por una cifra aislada.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →Hardware relacionado
Ejemplos actuales de superordenador personal para IA
Compara sistemas GB10 y una GPU profesional después de calcular memoria y velocidad.
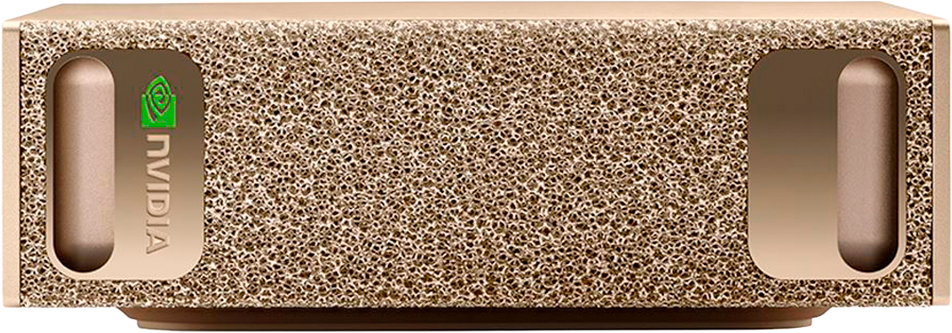
NVIDIA · 4 TB
NVIDIA DGX Spark
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
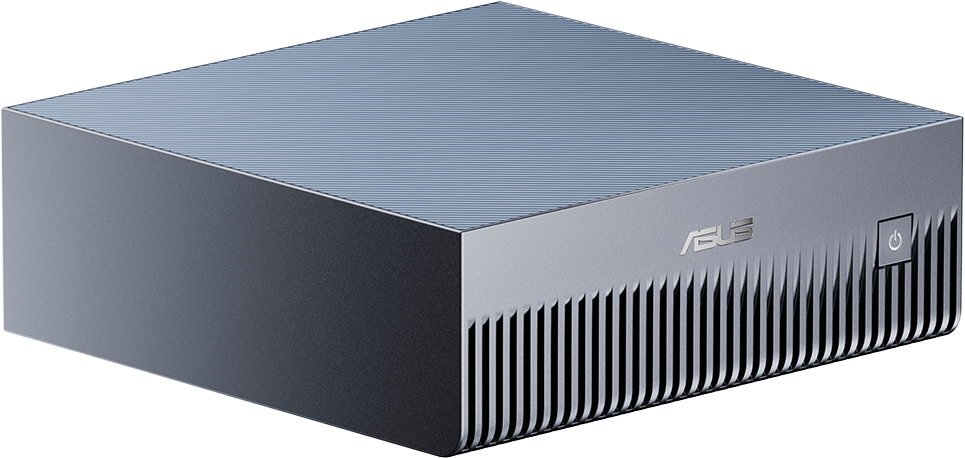
GB10 · 1, 2 o 4 TB
ASUS Ascent GX10
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
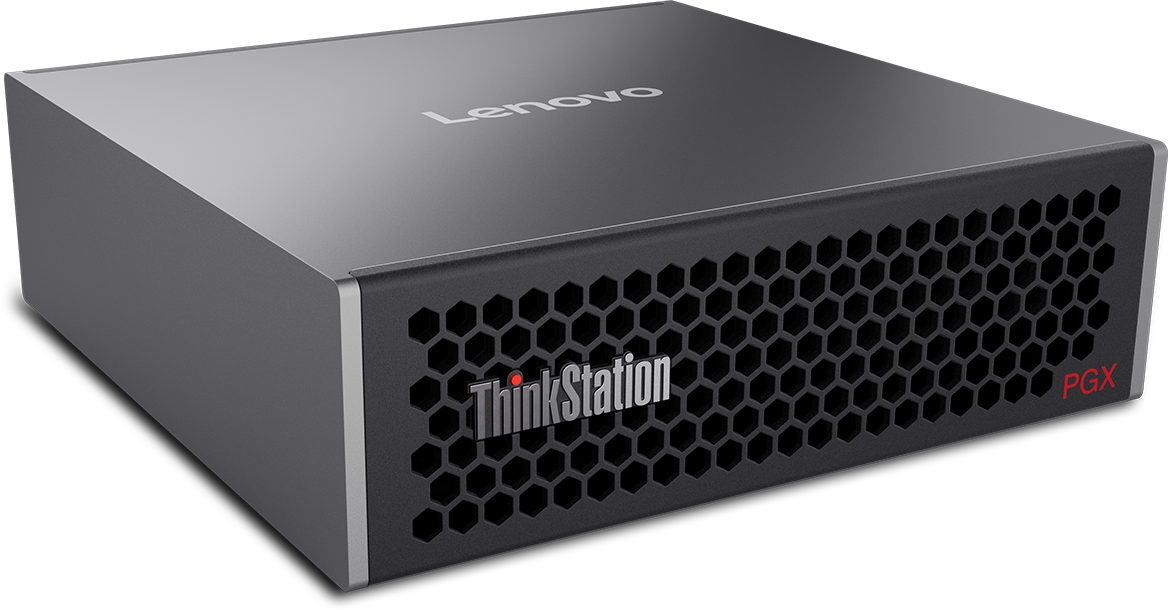
GB10 · 1, 2 o 4 TB
Lenovo ThinkStation PGX
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
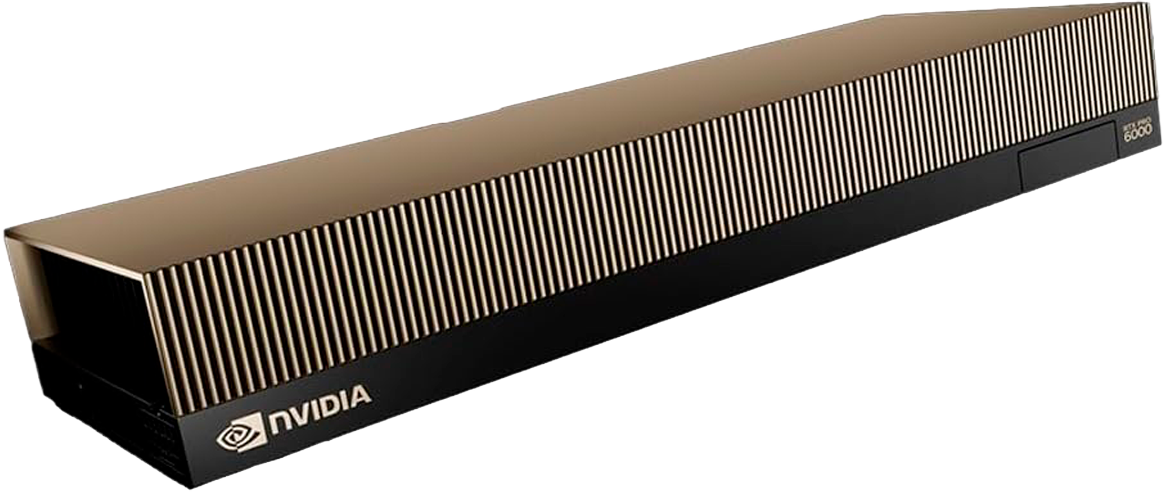
GPU de servidor · 96 GB
RTX PRO 6000 Blackwell
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
Un equipo construido alrededor de la carga de IA
En palabras sencillas
No es "el PC más rápido", igual que una furgoneta no es el coche más rápido: es el vehículo capaz de cargar el paquete completo. Aquí el paquete es el modelo de IA, y esta categoría de equipo existe para que quepan los grandes.
Un superordenador personal de IA es una estación compacta que acerca capacidades antes reservadas a servidores o centros de datos. Su finalidad es ejecutar, adaptar y evaluar modelos junto al usuario o dentro de la red de la organización. Esto reduce transferencias de datos y acelera la iteración, aunque no elimina las obligaciones de seguridad, gobierno y mantenimiento.
La palabra «superordenador» no convierte el equipo en un sustituto de un clúster científico. Describe una nueva categoría comercial y técnica centrada en aceleradores de IA, memoria amplia y herramientas de desarrollo. Por eso hay que leer las precisiones: un petaFLOP en FP4 para IA no equivale a un petaFLOP FP64 de simulación científica.
El ejemplo compacto es NVIDIA DGX Spark, con 128 GB coherentes y GB10. En una escala superior, DGX Station incorpora GB300 y hasta 748 GB coherentes.
La memoria es la mesa de trabajo del modelo
Los pesos del modelo, la caché KV, el contexto, los adaptadores, los índices y el propio motor ocupan memoria. Cuando todo cabe en la VRAM de una GPU rápida, esa GPU suele proporcionar el mejor tiempo de respuesta. Cuando deja de caber, aparecen transferencias a RAM o CPU que pueden reducir mucho la velocidad.
La memoria unificada amplía la mesa de trabajo y permite que CPU y GPU compartan un espacio coherente. Esa capacidad no debe confundirse con un ancho de banda ilimitado: LPDDR5X, GDDR7 y HBM3e tienen perfiles distintos. El dimensionamiento correcto considera ambos ejes.
Tamaño del modelo
Un mismo modelo ocupa cantidades diferentes según precisión y cuantización. La etiqueta de parámetros no basta para calcular la memoria total.
Caché KV
Las conversaciones largas, el código y los documentos reservan memoria adicional. El consumo crece con el contexto y la concurrencia.
Usuarios y lote
Varios usuarios simultáneos o un lote mayor elevan la demanda de memoria y cambian el equilibrio entre latencia y capacidad.
Seis criterios antes de comprar
- Define la familia y el formato del modelo. No dimensionas igual Qwen, Llama, Gemma, DeepSeek-R1 o gpt-oss; tampoco una cuantización ligera y otra de mayor precisión.
- Fija el contexto útil. El límite anunciado por una aplicación no implica que resulte eficiente utilizarlo al máximo.
- Separa prefill y generación. Leer un documento y producir una respuesta son fases distintas y pueden tener cuellos de botella diferentes.
- Cuenta usuarios y procesos. Una sesión individual no representa una oficina, un aula ni una API con trabajos simultáneos.
- Comprueba la pila de software. CUDA, controladores, contenedores, Ollama, TensorRT-LLM, llama.cpp o PyTorch deben ser compatibles con la arquitectura.
- Incluye operación y seguridad. Copias, actualización, monitorización, permisos, red, retención y recuperación forman parte de la solución.
Cuatro formas de ejecutar IA cerca del usuario
| Tipo | Punto fuerte | Límite habitual |
|---|---|---|
| CPU o equipo existente | Validar el caso con poca inversión inicial | Menor velocidad y modelos pequeños o muy cuantizados |
| GPU de consumo o profesional | Gran ancho de banda y baja latencia | La VRAM marca el tamaño máximo eficiente |
| Memoria unificada sin CUDA | Capacidad amplia y facilidad de uso | Compatibilidad y rendimiento dependen del ecosistema |
| Superordenador personal NVIDIA | Memoria amplia, CUDA y plataforma integrada | El ancho de banda y el presupuesto deben justificarse por la carga |
El recomendador interactivo conserva una regla importante: desarrollo con CUDA no termina en un mini PC sin CUDA, e imagen o vídeo priorizan memoria de GPU.
Qué puedes construir
RAG con documentación interna
Busca fragmentos relevantes y los entrega al modelo para responder con contexto. Consulta la guía de RAG para empresa.
Agentes con herramientas
El modelo propone acciones, pero los permisos, validadores y registros deben limitar lo que puede ejecutar. Consulta agentes en local.
Asistentes multiusuario
Open WebUI añade una interfaz compartida, usuarios, permisos y conexión a Ollama u otros proveedores. Consulta la arquitectura propuesta.
Imagen y vídeo por nodos
ComfyUI organiza modelos y operaciones en flujos reproducibles. La memoria necesaria depende de resolución, lote y nodos. Consulta la guía de ComfyUI.
Información técnica opcional: dimensionamiento y arquitectura de hardware
No necesitas esta parte para completar el tutorial básico. Ábrela únicamente si vas a administrar el sistema, compartirlo con más personas o resolver una incidencia.
Entender CPU, GPU, memoria, almacenamiento y red como un único sistema
La inferencia no depende de una sola cifra. Los pesos deben llegar al acelerador, el contexto se procesa, los tokens se generan y los resultados se sirven a una aplicación. Un cuello de botella en memoria, CPU, disco o red puede ocultar la capacidad de la GPU.
CPU. Prepara datos, ejecuta conectores y coordina el proceso. En RAG y agentes puede dedicar más tiempo a extracción, búsqueda o herramientas que a inferencia.
GPU. Ejecuta operaciones paralelas del modelo. Si los pesos y la caché caben en VRAM, una GPU discreta de gran ancho de banda suele ofrecer la mejor velocidad interactiva.
VRAM. Memoria unida a una GPU discreta. Es rápida y limitada. Cuando falta, parte del modelo puede descargarse a RAM con una pérdida importante de rendimiento.
Memoria unificada. CPU y GPU comparten un espacio coherente. Amplía el tamaño práctico de la carga y evita copias, aunque su rendimiento no se compara solo por capacidad.
Almacenamiento. Guarda modelos, índices, datasets y contenedores. La lectura afecta sobre todo a carga y cambio de modelo; capacidad, IOPS y fiabilidad importan.
Red. Une usuarios, datos y nodos. Para dos sistemas o un servicio multiusuario, latencia, ancho de banda, segmentación y redundancia forman parte del diseño.
Refrigeración. Determina si el equipo mantiene rendimiento durante cargas largas. Un benchmark corto no revela limitaciones térmicas sostenidas.
Software. Controladores, CUDA, framework, cuantización y motor pueden cambiar compatibilidad y velocidad tanto como el hardware.
Por eso «cuántos TOPS» o «cuántos petaFLOPS» no resuelve la compra. Primero define el modelo, la precisión, el contexto y la carga; después comprueba qué componente limita.
Estimar cuánto cabe y reservar margen para servirlo
pesos aproximados = parámetros × bits / 8
memoria total = pesos + caché KV + buffers + activaciones + margen
La fórmula de pesos es una primera aproximación. El fichero y el programa que ejecuta el modelo añaden metadatos y buffers. La caché KV crece con longitud de contexto, arquitectura, lote y sesiones simultáneas. Una variante que entra en memoria con un prompt corto puede dejar de entrar cuando se añade historial, documentos o herramientas.
| Pregunta | Dato necesario | Impacto |
|---|---|---|
| ¿Qué modelo? | Familia, variante y parámetros | Tamaño de pesos y compatibilidad |
| ¿Qué precisión? | FP, BF o cuantización exacta | Memoria, calidad y velocidad |
| ¿Qué contexto? | Tokens reales de entrada | Caché KV y tiempo de prefill |
| ¿Cuántos usuarios? | Sesiones simultáneas y cola | Cachés, memoria y latencia |
| ¿Qué salida? | Tokens o imágenes por trabajo | Tiempo de generación |
| ¿Qué herramientas? | RAG, visión, agentes, vídeo | Componentes y contexto adicionales |
Margen operativo
No dimensionas para que una demostración termine una vez. Reserva memoria para el sistema, la interfaz, el programa que ejecuta el modelo y variaciones de carga. Si la configuración funciona solo con todo lo demás cerrado, no está preparada para usuarios ni actualizaciones.
Dimensionar de forma distinta chat, RAG, agentes, imagen y ajuste
Chat y generación
Dominan los pesos, la caché KV y la velocidad por token. Mide prefill y generación por separado.
Documentos y fuentes
Añade embeddings, búsqueda, reranking y contexto. La calidad de recuperación puede importar más que aumentar el modelo.
Herramientas y varios pasos
El contexto crece con esquemas y resultados. La latencia total incluye cada llamada externa.
Difusión y nodos
Modelo, resolución, lote, VAE y ControlNet determinan picos de VRAM. Una GPU rápida suele ser prioritaria si el flujo cabe.
Secuencias largas
Fotogramas, resolución y duración elevan memoria y tiempo. Prueba el flujo de trabajo final, no una imagen aislada.
Entrenamiento y adaptadores
Optimizador, activaciones, lote y longitud consumen más que inferencia. LoRA reduce parámetros entrenables, pero no elimina la necesidad de medir.
Elegir entre equipo actual, GPU discreta, memoria unificada y estación de gran escala
| Plataforma | Fortaleza | Límite que debes comprobar |
|---|---|---|
| Equipo existente | Validar utilidad sin inversión dedicada | Memoria, velocidad y compatibilidad del acelerador |
| GPU NVIDIA de consumo | Buen rendimiento cuando el modelo cabe | VRAM, refrigeración, soporte y uso continuo |
| RTX PRO 6000 Blackwell | Gran VRAM, ancho de banda y entorno profesional | Configuración del servidor, consumo y carga concreta |
| NVIDIA DGX Spark | 128 GB unificados, CUDA y formato compacto | Velocidad frente a una GPU discreta y compatibilidad ARM64 |
| Dos DGX Spark | Emparejamiento oficial para modelos de hasta 405B | Software compatible y enlace ConnectX |
| NVIDIA DGX Station | Hasta 748 GB coherentes y operación de mayor escala | Proyecto, alimentación, soporte y carga multiusuario |
| Flota o servidor | Réplicas, colas y alta disponibilidad | Coordinación de pasos, red, almacenamiento y operación |
Capacidad y velocidad son ejes diferentes. Una GPU discreta puede ser claramente más rápida cuando el modelo cabe. DGX Spark empieza a aportar valor donde la VRAM convencional se agota. DGX Station aumenta la escala de memoria y servicio, no convierte todas las cargas en más rápidas por definición.
Ejecutar un benchmark que represente el trabajo real
- Fija el artefacto. Modelo, cuantización, versión de programa que ejecuta el modelo, prompt, contexto y parámetros.
- Separa carga, prefill y generación. El primer arranque, la lectura del contexto y los tokens de salida son fases distintas.
- Calienta el sistema. Repite después de que el modelo esté residente y conserva también la medición en frío.
- Prueba concurrencia. Uno, varios usuarios y el pico previsto. Registra cola y percentiles, no solo media.
- Ejecuta durante suficiente tiempo. Comprueba temperatura, frecuencia, memoria y estabilidad sostenida.
- Mide calidad. Una cuantización más rápida no sirve si falla el contrato de la tarea.
- Documenta energía y ruido. Forman parte del entorno de uso, especialmente en oficina.
| Métrica | Qué explica | Error habitual |
|---|---|---|
| Tiempo de carga | Cambio o primera apertura del modelo | Mezclarlo con generación |
| Tiempo hasta primer token | Experiencia inicial y prefill | Comparar prompts de longitud distinta |
| Tokens por segundo | Velocidad de salida | Ignorar cuantización y longitud |
| Latencia por trabajo | Tiempo de negocio completo | Medir solo la GPU |
| Pico de memoria | Margen y capacidad | Medir sin contexto ni usuarios |
| Percentil alto | Experiencia bajo carga | Utilizar solo promedio |
Diseñar red, almacenamiento, acceso y continuidad antes de compartir el equipo
Un superordenador personal puede ser una estación o un servidor para el equipo. En el segundo caso necesita identidad, HTTPS, segmentación, límites, copias y monitorización. No publiques Ollama, ComfyUI o una consola de administración directamente en Internet.
- Ubicación física, alimentación y refrigeración adecuadas
- Usuarios y grupos con mínimo privilegio
- Proxy o aplicación de acceso, no puertos internos expuestos
- Almacenamiento separado para modelos, datos y copias
- Versiones de controladores, contenedores y modelos registradas
- Métricas de memoria, temperatura, cola y errores
- Procedimiento de actualización y reversión
- Continuidad del proceso cuando la IA no está disponible
Si varias aplicaciones comparten el equipo, asigna cuotas y horarios. Un fine-tuning puede expulsar un modelo de chat de memoria; una generación de vídeo puede bloquear la cola interactiva. Separa servicios o planifica recursos.
Una secuencia de compra que evita empezar por la marca del equipo
- Demuestra la tarea. Ejecuta un modelo pequeño en el equipo disponible.
- Aprueba una familia y variante. Utiliza tus casos, licencia y formato de salida.
- Fija contexto y usuarios. Son parte de la memoria, no un detalle posterior.
- Mide si cabe. Si entra en VRAM con margen, prioriza una GPU rápida.
- Escala memoria. Si no cabe, compara 128 GB de DGX Spark, gran VRAM profesional o la escala de DGX Station.
- Escala servicio. Si el problema son usuarios, estudia réplicas y colas en vez de un modelo más grande.
- Valida el conjunto. Software, red, almacenamiento, soporte y recuperación.
Recomendación técnica
Empezar el dimensionamientoTrae modelo, contexto, usuarios y tiempo objetivo
Con esos datos se puede comparar una GPU, DGX Spark, dos unidades, RTX PRO o DGX Station sin depender de una cifra comercial aislada.
Cómo pasó la IA de una plataforma de centro de datos a un equipo de sobremesa
- Plataformas integradas. Las primeras familias DGX reunieron GPU, interconexión y software en sistemas preparados para centros de datos.
- Modelos abiertos descargables. La disponibilidad de pesos permitió ejecutar, evaluar y adaptar modelos fuera de servicios cerrados.
- Memoria como límite principal. El tamaño de pesos y caché convirtió la capacidad accesible por el acelerador en una decisión tan importante como el cómputo.
- Superchips CPU+GPU. La conexión coherente y la memoria compartida hicieron viable una clase de equipos compactos con un entorno CUDA completo.
- Escala de estación. DGX Station amplía el mismo objetivo hacia cargas multiusuario y una reserva de memoria muy superior.
La denominación «superordenador personal de IA» describe este cambio de integración y capacidad. No significa que un petaFLOP FP4 sea comparable directamente con el rendimiento FP64 de un superordenador científico. Son precisiones y cargas diferentes.
GPU, memoria unificada y estación: territorios distintos
| Plataforma | Ventaja | Límite que debes comprobar | Uso típico |
|---|---|---|---|
| Equipo actual | Coste de entrada mínimo y validación inmediata | Memoria, aceleración y estabilidad | Prueba de modelo y flujo |
| GPU NVIDIA discreta | Gran velocidad cuando todo cabe en VRAM | Pesos, caché, lote y otros procesos | Inferencia, imagen, vídeo y entrenamiento |
| DGX Spark | 128 GB coherentes, CUDA y formato compacto | Rendimiento de la carga y compatibilidad ARM64 | Modelos y contextos que superan la VRAM habitual |
| ASUS Ascent GX10 | Mismo superchip GB10 en otra configuración de fabricante | Referencia, almacenamiento, conexiones, soporte y canal | Alternativa dentro de la clase GB10 |
| DGX Station | 748 GB coherentes y administración de estación compartida | Proyecto, infraestructura y nivel de servicio | Cargas grandes, varios usuarios y partición de recursos |
| Memoria unificada sin CUDA | Capacidad amplia para programa que ejecuta el modelos compatibles | Software, kernels y herramientas que exigen CUDA | Chat, experimentación y flujos no dependientes de CUDA |
La decisión correcta empieza con una variante de modelo, longitud de contexto, número de usuarios, latencia objetivo y software. Continúa con la guía de DGX Spark, la comparativa con ASUS GX10 o el análisis de DGX Station.
Dimensiona desde el flujo, no desde el nombre del equipo
El modelo, la precisión, el contexto, la concurrencia y el software permiten calcular una plataforma defendible y evitar capacidad insuficiente o sobredimensionada.
Abrir el recomendadorLas reglas de conexión · ¿1, 2, 3 o 4 nodos?
- Dos nodos: mantienen la referencia oficial de hasta 405B con software compatible y un enlace QSFP directo.
- Tres o cuatro nodos: NVIDIA Sync valida un anillo de tres y topologías de hasta cuatro mediante switch; repartir un modelo exige un programa que ejecuta el modelo compatible y pruebas reales.
- Más usuarios: si el modelo cabe en una unidad, suele ser más sencillo añadir réplicas o colas que dividir el modelo. Ver topologías y límites →
Fuentes técnicas y criterio editorial
Las especificaciones, funciones y límites descritos se contrastan con documentación primaria de NVIDIA GB10 y sistemas OEM, NVIDIA RTX PRO. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
NVIDIA DGX Spark · ASUS Ascent GX10: especificaciones · Lenovo ThinkStation PGX · RTX PRO 6000 Blackwell Server Edition · Familia RTX PRO 6000 Blackwell
Respuestas directas
¿Qué es un superordenador personal de IA?
Es un equipo de puesto de trabajo diseñado para desarrollar y ejecutar cargas de IA localmente, con gran capacidad de memoria, aceleración especializada y una pila de software orientada a modelos.
¿Es lo mismo que un PC con una GPU potente?
No siempre. Un PC con GPU puede ser más rápido cuando el modelo cabe en VRAM. Un superordenador personal prioriza memoria disponible, coherencia, interconexión y una plataforma integrada para cargas mayores.
¿La memoria unificada es igual que la VRAM?
No. CPU y GPU comparten un espacio coherente, pero la tecnología y el ancho de banda pueden diferir de GDDR o HBM. Debes valorar capacidad y velocidad por separado.
¿Cuánta memoria necesito para IA local?
Depende del tamaño y formato del modelo, la cuantización, el contexto, la caché KV, el lote, los usuarios y los procesos auxiliares. Es recomendable medir el conjunto completo y reservar margen.
¿Un petaFLOP indica cuántos tokens por segundo obtendré?
No. La cifra de cómputo depende de la precisión y otras condiciones. Los tokens por segundo también dependen de memoria, motor, contexto, lote, arquitectura del modelo y software.