Describe una tarea que ya exista y quién comprobará el resultado.
Asistente de decisión · cálculo local
Qué IA puede usar tu empresa: un plan sencillo en ocho preguntas
El recomendador transforma tu objetivo en una primera prueba comprensible. La información técnica queda aparte para quien vaya a administrar el sistema.
Ruta para pymes
No necesitas conocer modelos ni arquitectura para usar este recomendador
Responde pensando en una tarea real: qué entra, qué salida esperas, quién la revisa y qué datos utiliza. El resultado propone un punto de partida y separa lo imprescindible de lo avanzado.
Pasa al recomendador de hardware cuando el caso esté claro.
Integraciones, agentes y despliegues para varios departamentos.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Compra en nuestras tiendas oficiales
AI Supercomputers te ayuda a elegir; el pedido se completa en una tienda del grupo ietres
Esta web publica las guías, comparativas y recomendadores. La ficha comercial, la disponibilidad, la reserva y la compra se gestionan en una de nuestras dos tiendas oficiales.
 tienda.ietres.comTienda multimarca del grupo. Aquí se comercializa NVIDIA DGX Spark.
 ietresinformatica.comCanal profesional del grupo para ASUS, Lenovo, RTX PRO y accesorios de IA.
Disponibilidad y reservas. La disponibilidad cambia por referencia. Si una ficha aparece sin stock, consulta la tienda: algunas unidades pueden reservarse o pedirse sobre una próxima entrada. El plazo y las condiciones se confirman antes de comprar.
Pregunta 1 de 8
El cálculo se realiza en el navegador. No se almacenan ni se transmiten las respuestas.
Cómo interpretar la salida
El resultado te indica por dónde empezar
En palabras sencillas
El resultado del recomendador es el punto de partida, no el pedido cerrado: como la orientación de un buen dependiente antes de probarte la talla. Con esa arquitectura inicial se hace la prueba con tus datos reales y, si encaja, entonces se compra — en ese orden.
El resultado describe una arquitectura inicial coherente con tus respuestas. Las familias de modelos son candidatas para probar; el hardware es un punto de partida; la autonomía indicada es el máximo razonable antes de controles adicionales. La decisión final debe apoyarse en datos reales de calidad, memoria, concurrencia y error.
Modelo
Compara varias familias con el mismo dataset. No elijas solo por tamaño o una clasificación pública que no representa tu tarea.
Datos
RAG sirve para conocimiento cambiante y con fuentes. Las bases de datos y APIs deben consultarse mediante herramientas con filtros y permisos, no volcarse indiscriminadamente al contexto.
Hardware
Una GPU rápida suele ganar en latencia cuando todo cabe en VRAM. La memoria coherente empieza a aportar valor cuando la carga deja de caber o el desarrollo requiere ese entorno.
Hardware relacionado
Equipos que pueden aparecer en el resultado
El recomendador empresarial define el caso; este carrusel muestra las familias que después se comparan por capacidad y velocidad.
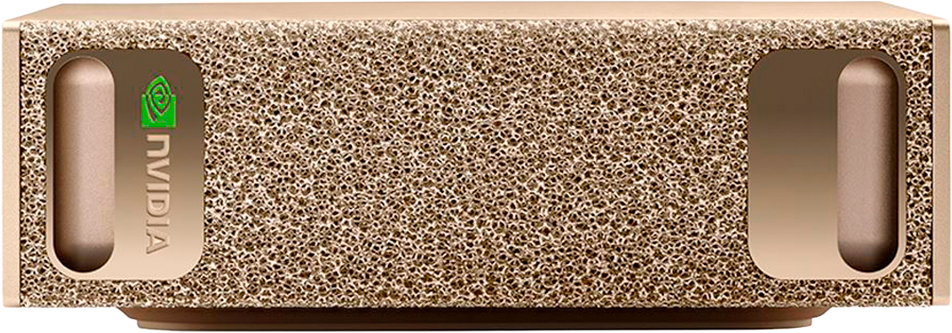
NVIDIA · 4 TB
NVIDIA DGX Spark
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
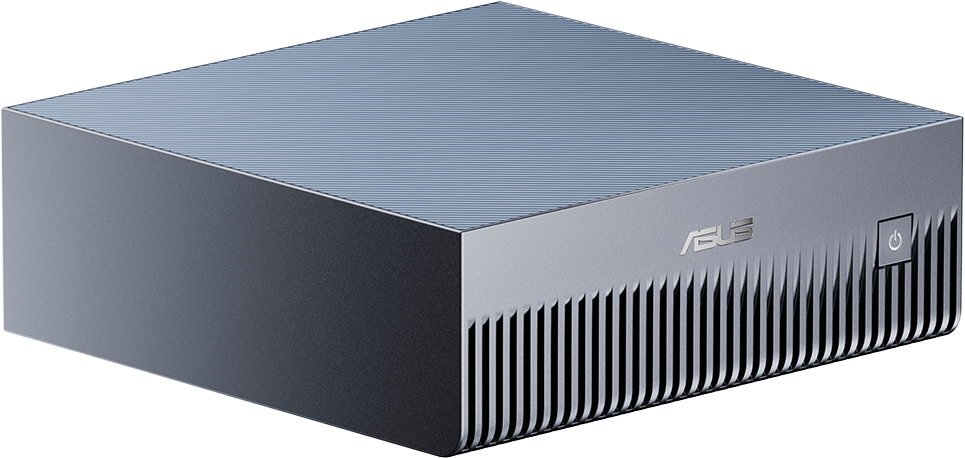
GB10 · 1, 2 o 4 TB
ASUS Ascent GX10
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
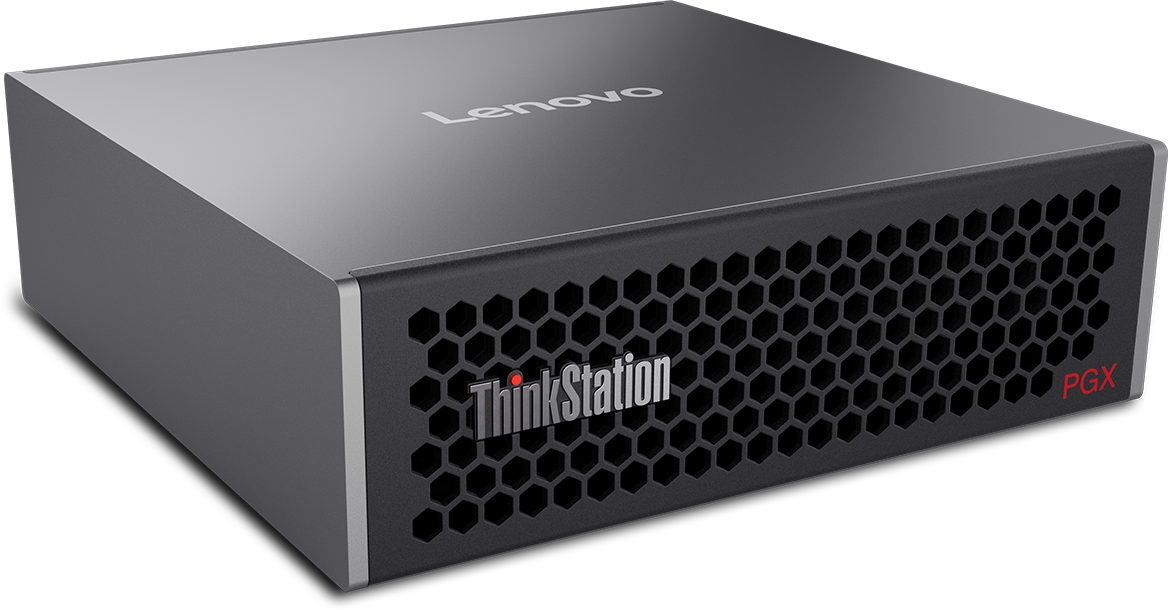
GB10 · 1, 2 o 4 TB
Lenovo ThinkStation PGX
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
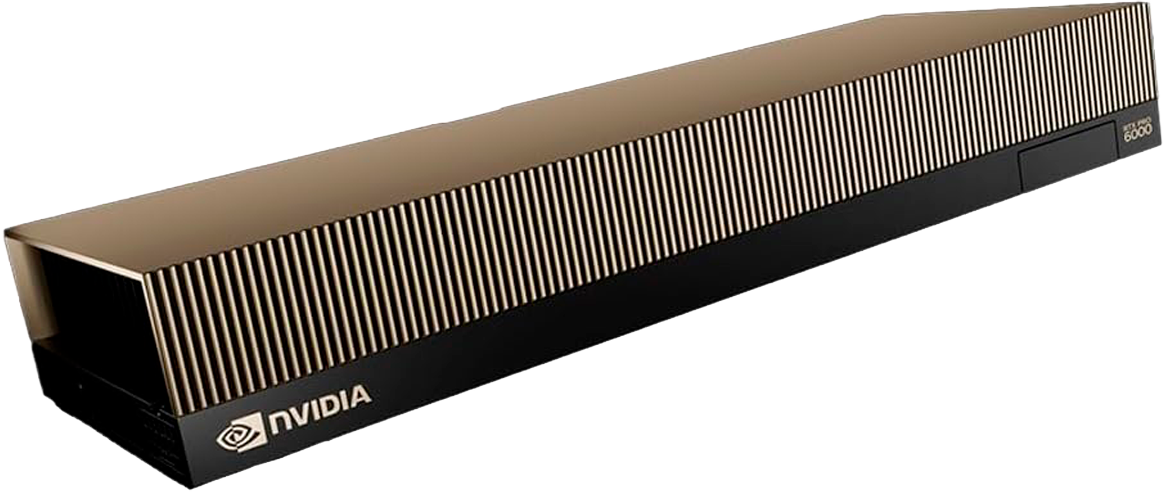
GPU de servidor · 96 GB
RTX PRO 6000 Blackwell
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
Después del resultado01 02 03
Convierte el plan inicial en una decisión de hardware
El primer recomendador aclara el caso de uso. El segundo compara capacidad, VRAM y formato. Solo después tiene sentido abrir una ficha comercial.
Guarda el plan
Copia familias, datos, controles, concurrencia y criterio de aceptación.
Mide una carga real
Registra memoria, contexto, primer token, latencia total y usuarios simultáneos.
Elige y compra
Compara GPU profesional y memoria coherente con la misma prueba.
Preguntas frecuentes
Qué puede y qué no puede decidir este recomendador
¿Guarda mis respuestas?
No. La lógica se ejecuta en el navegador, sin cookies ni almacenamiento local. Los enlaces comerciales solo abren las páginas indicadas; este recomendador no envía tus respuestas.
¿El resultado elige una versión concreta de un modelo?
No. Propone familias y criterios de evaluación. Las variantes cambian y deben verificarse en la biblioteca del programa que ejecuta el modelo, junto con licencia, tamaño, cuantización y requisitos.
¿Puede recomendar un agente autónomo?
No concede autonomía ilimitada. Para tareas con impacto recomienda respuestas, borradores o acciones reversibles con herramientas acotadas, validación y aprobación cuando corresponda.
¿Sustituye una auditoría de seguridad o protección de datos?
No. Señala controles técnicos iniciales. La organización debe completar análisis de riesgos, funciones, base jurídica, contratos, evaluación de impacto cuando proceda y procedimientos internos.
Las reglas de conexión · ¿1, 2, 3 o 4 nodos?
- Dos nodos: mantienen la referencia oficial de hasta 405B con software compatible y un enlace QSFP directo.
- Tres o cuatro nodos: NVIDIA Sync valida un anillo de tres y topologías de hasta cuatro mediante switch; repartir un modelo exige un programa que ejecuta el modelo compatible y pruebas reales.
- Más usuarios: si el modelo cabe en una unidad, suele ser más sencillo añadir réplicas o colas que dividir el modelo. Ver topologías y límites →
Fuentes técnicas y criterio editorial
Las especificaciones, funciones y límites descritos se contrastan con documentación primaria de Open WebUI, documentos y agentes, Ollama y modelos, NVIDIA GB10 y sistemas OEM, NVIDIA RTX PRO. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Workspace de Open WebUI · Knowledge y RAG · Modelos configurados · Seguridad de Tools · Documentación oficial de Ollama · Biblioteca oficial de modelos · Contexto y comprobación de offload · NVIDIA DGX Spark · ASUS Ascent GX10: especificaciones · Lenovo ThinkStation PGX · RTX PRO 6000 Blackwell Server Edition · Familia RTX PRO 6000 Blackwell