Valida primero una tarea y un modelo; confirma que la capacidad es realmente el límite.
Análisis técnico · NVIDIA GB10
NVIDIA DGX Spark: análisis, especificaciones, rendimiento y compra
DGX Spark combina el superchip GB10 Grace Blackwell, 128 GB de memoria unificada coherente y el ecosistema CUDA en un formato compacto. Su valor no consiste en sustituir siempre a una GPU rápida, sino en ejecutar cargas que dejan de caber en la VRAM convencional.
128 GB de memoria unificadaHasta 200B en una unidadEmparejamiento de dos unidades hasta 405B
Compra en nuestras tiendas oficiales
AI Supercomputers te ayuda a elegir; el pedido se completa en una tienda del grupo ietres
Esta web publica las guías, comparativas y recomendadores. La ficha comercial, la disponibilidad, la reserva y la compra se gestionan en una de nuestras dos tiendas oficiales.
 tienda.ietres.comTienda multimarca del grupo. Aquí se comercializa NVIDIA DGX Spark.
 ietresinformatica.comCanal profesional del grupo para ASUS, Lenovo, RTX PRO y accesorios de IA.
Disponibilidad y reservas. La disponibilidad cambia por referencia. Si una ficha aparece sin stock, consulta la tienda: algunas unidades pueden reservarse o pedirse sobre una próxima entrada. El plazo y las condiciones se confirman antes de comprar.
Decisión rápida
Compra DGX Spark cuando la capacidad sea el límite
Si la carga cabe íntegramente en la VRAM de una GPU, mide esa vía primero. Spark cobra sentido cuando necesitas 128 GB coherentes, formato compacto y compatibilidad con el software elegido.
Ruta para pymes
DGX Spark encaja cuando los 128 GB son la razón de la compra
Para modelos pequeños o una primera prueba puede bastar el ordenador actual. Spark empieza a tener sentido cuando quieres un equipo dedicado, una biblioteca local amplia o modelos y contextos que superan la VRAM habitual.
Una unidad para servicio local dedicado; la ficha disponible incorpora 4 TB de almacenamiento.
Bundle x2, tres o cuatro nodos y software distribuido.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
NVIDIA DGX Spark: encaje rápido antes de comprar
Capacidad de 128 GB coherentes en formato compacto para modelos que exceden la VRAM habitual.
Ollama y cargas compatibles con Arm64 que justifican más memoria.
No sustituye automáticamente a una GPU cuando la carga cabe en VRAM y prima la velocidad.
Modelo, cuantización, contexto, compatibilidad y tiempo de respuesta.
Ruta de montaje
Lo que conviene tener a mano (y cómo sabrás que vas bien)
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
El modelo o flujo de trabajo que deseas probar, su formato y una medida de memoria en tu equipo actual.
Saber si Spark aporta capacidad útil frente a una GPU convencional y qué debes medir antes de comprar.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →Galería del equipo
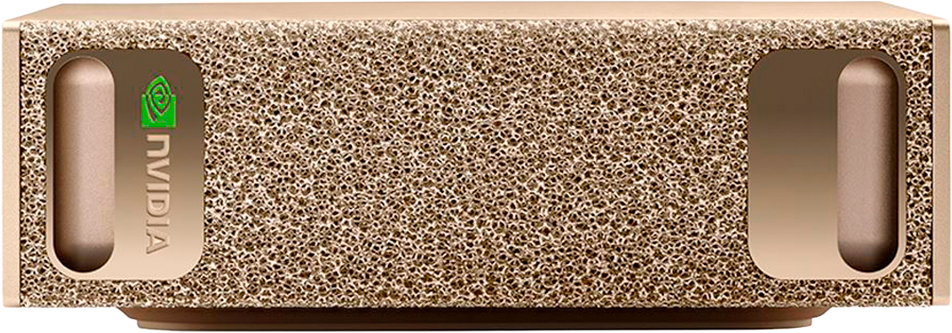
Frontal, conexiones y arquitectura interna
Las imágenes locales sustituyen los recursos remotos y mantienen el fondo transparente donde procede.


Hardware relacionado
Compara DGX Spark con ASUS, Lenovo y una GPU de 96 GB
La capacidad coherente es la ventaja central; la velocidad debe medirse con la misma carga.
NVIDIA · 4 TB
NVIDIA DGX Spark
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
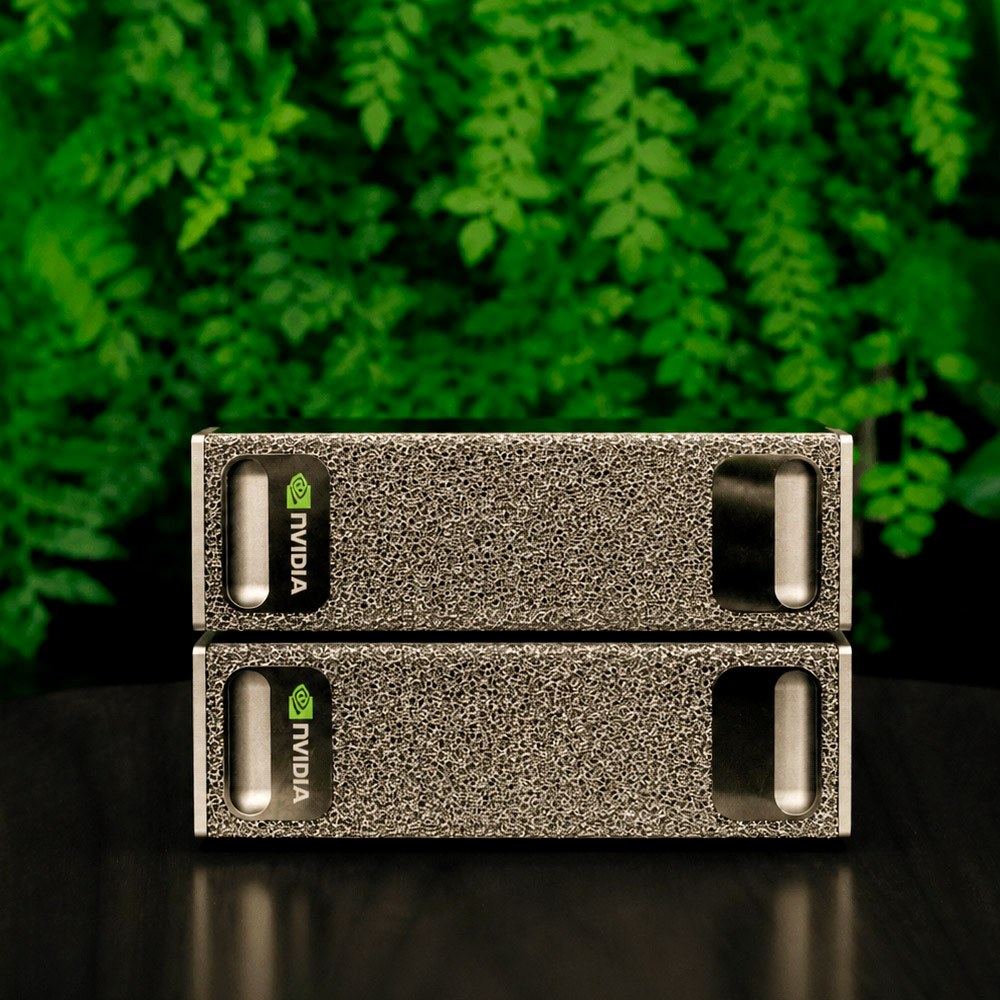
NVIDIA · Bundle x2
DGX Spark Bundle x2
Dos unidades Founders Edition en una única ficha comercial para preparar una pareja compatible. Comprueba en la ficha el contenido exacto y añade el cable QSFP adecuado cuando corresponda.
Compra entienda ietres
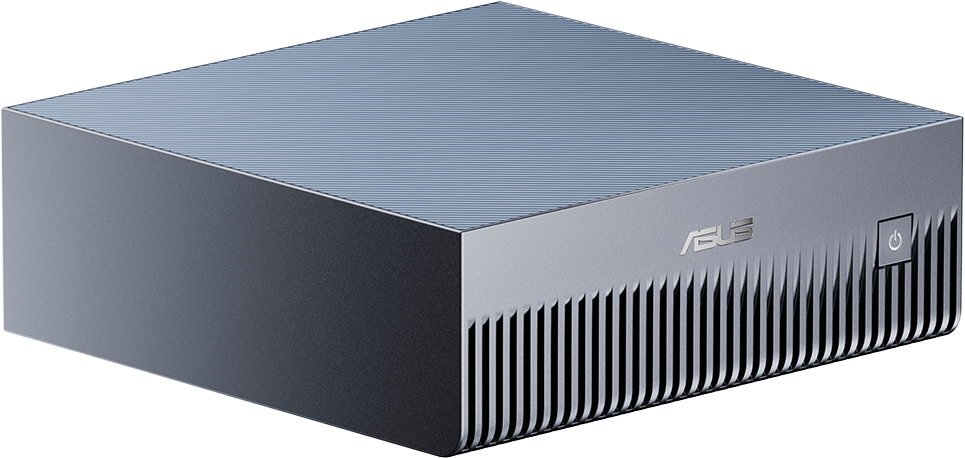
GB10 · 1, 2 o 4 TB
ASUS Ascent GX10
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
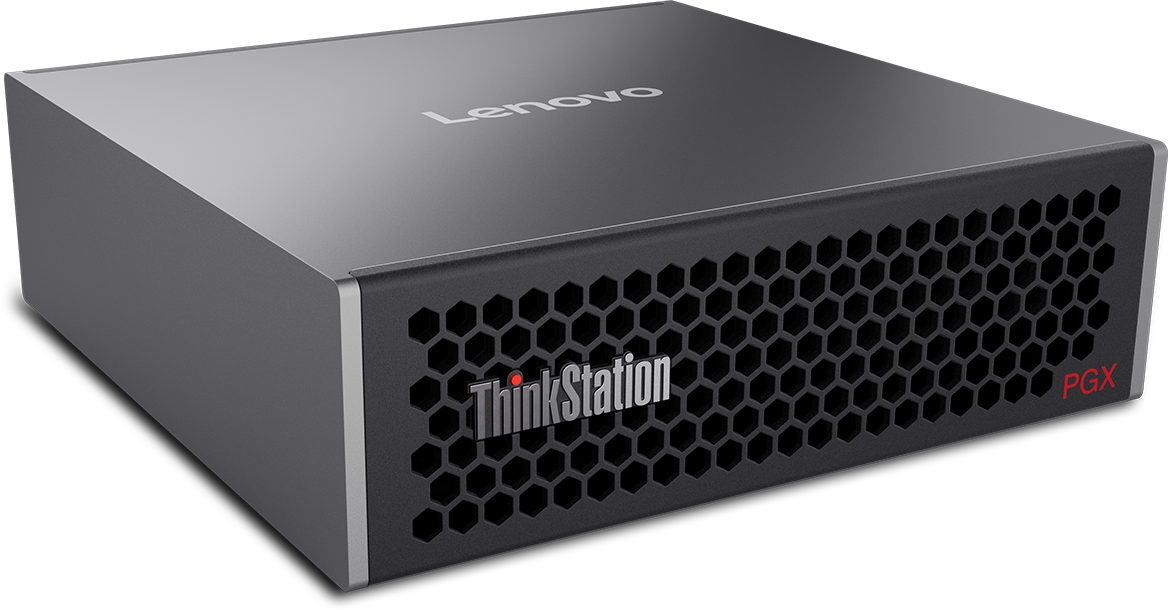
GB10 · 1, 2 o 4 TB
Lenovo ThinkStation PGX
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
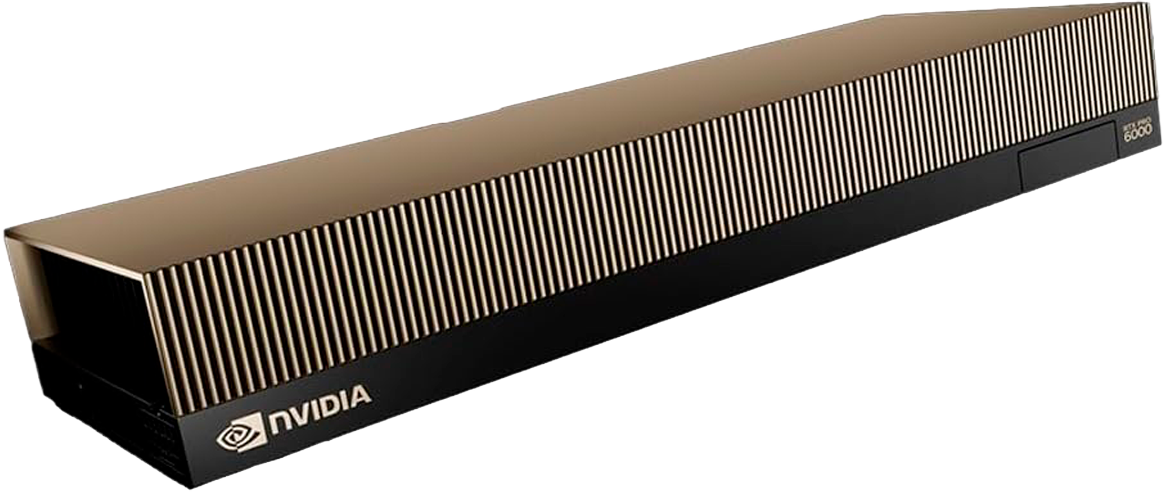
GPU de servidor · 96 GB
RTX PRO 6000 Blackwell
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
1 petaFLOPmáximo FP4 para IA, con las condiciones del fabricante
273 GB/sancho de banda de memoria
10 GbEred Ethernet integrada
1,2 kgequipo compacto de sobremesa
Qué es DGX Spark y qué problema resuelve
DGX Spark pertenece a la categoría de superordenadores personales de IA: equipos concebidos para desarrollar, ajustar y ejecutar modelos cerca del usuario, con una reserva de memoria superior a la habitual en una tarjeta gráfica de consumo. CPU y GPU comparten un espacio coherente de 128 GB mediante NVLink-C2C, lo que reduce la necesidad de copiar datos entre memorias separadas.
La memoria unificada puede entenderse como una mesa de trabajo común. CPU y GPU acceden al mismo conjunto de datos, aunque eso no convierte toda la memoria en VRAM idéntica a GDDR o HBM. El ancho de banda de 273 GB/s es notable para el formato, pero está por debajo del de muchas GPU discretas. Por eso una GPU con suficiente VRAM suele mantener ventaja de velocidad; Spark prioriza capacidad, coherencia y compatibilidad con CUDA.
La plataforma resulta relevante para RAG con contextos amplios, agentes que mantienen varios componentes residentes, modelos grandes cuantizados, prototipos CUDA y determinados procesos de ajuste. Para modelos pequeños, una estación con GPU puede ser más sencilla y rápida.
Especificaciones que cambian la decisión
| Elemento | Configuración | Interpretación práctica |
|---|---|---|
| Superchip | NVIDIA GB10 Grace Blackwell | GPU Blackwell y CPU Arm de 20 núcleos en un módulo coherente |
| CPU | 10 núcleos Cortex-X925 y 10 Cortex-A725 | Procesamiento de datos, coordinación de pasos y tareas de sistema junto a la GPU |
| Memoria | 128 GB LPDDR5X, 273 GB/s | Capacidad para modelos y contextos que exceden la VRAM de consumo |
| Cómputo | Hasta 1 petaFLOP FP4 con dispersión | Métrica de IA de baja precisión; no equivale a FP64 científico |
| GPU | 6.144 núcleos CUDA y Tensor Cores Blackwell | Compatibilidad con CUDA y bibliotecas optimizadas de NVIDIA |
| Almacenamiento | Unidad NVMe autocifrada; la Founders Edition comercializada incorpora 4 TB | Espacio local para modelos, índices y conjuntos de trabajo |
| Red | 10 GbE, Wi-Fi 7, Bluetooth 5.4 y ConnectX-7 | Conectividad de oficina y enlace de alta velocidad entre dos unidades |
| Puertos | Cuatro USB-C y HDMI 2.1a | Periféricos, almacenamiento y salida de vídeo |
| Formato | 150 × 150 × 50,5 mm; 1,2 kg | Instalación directa en un puesto de trabajo |
| Alimentación | Fuente externa de 240 W; TDP del GB10 de 140 W | La potencia de la fuente no equivale a consumo continuo del sistema |
Fuentes técnicas: ficha oficial de NVIDIA DGX Spark y documentación de software de DGX Spark. Comprueba la ficha comercial para confirmar SSD, contenido exacto del paquete y disponibilidad.
Rendimiento: separar prefill y generación
En palabras sencillas
Prefill mide la lectura inicial del texto de entrada y generación mide los tokens de salida. Son fases diferentes: una cifra alta de prefill no permite deducir cuánto tardará en escribirse toda la respuesta. Compara equipos únicamente con el mismo modelo, precisión, motor, longitud de entrada, longitud de salida y lote.
NVIDIA ha publicado mediciones controladas con tamaño de lote uno, entrada de 2.048 tokens y salida de 128 tokens. El prefill mide la lectura inicial del contexto; la generación mide la producción posterior de tokens. Son fases distintas y sus cifras no deben sumarse.
| Modelo y configuración | Motor | Prefill | Generación |
|---|---|---|---|
| gpt-oss 20B, MXFP4, una unidad | llama.cpp | 3.670,42 tok/s | 82,74 tok/s |
| gpt-oss 120B, MXFP4, una unidad | llama.cpp | 1.725,47 tok/s | 55,37 tok/s |
| Qwen 235B, NVFP4, dos unidades | TensorRT-LLM | 23.477,03 tok/s | 11,73 tok/s |
| Qwen3 14B, NVFP4, una unidad | TensorRT-LLM | 5.928,95 tok/s | 22,71 tok/s |
| Llama 3.1 8B, NVFP4, una unidad | TensorRT-LLM | 10.256,9 tok/s | 38,65 tok/s |
Estas cifras describen configuraciones concretas. Cambian con el motor, la cuantización, la longitud de contexto, la temperatura, el tamaño de lote, la versión del software y la proporción de capas residentes en el acelerador. Sirven para establecer un orden de magnitud, no como garantía universal.
Las optimizaciones de software también importan. NVIDIA ha documentado mejoras para modelos dispersos, decodificación especulativa y motores adaptados a GB10. La conclusión prudente es que el mismo hardware puede rendir mejor con una pila actualizada y una configuración adecuada, no que cualquier aplicación reciba automáticamente la misma mejora.
Generación de imágenes
NVIDIA publica 23 imágenes por minuto para Flux.1 12B Schnell FP4 a 1024 × 1024 y cuatro pasos, y siete imágenes por minuto para SDXL 1.0 BF16 con lote 2 y 50 pasos.
Cómo usar estas cifras
Reproduce el mismo modelo, precisión, backend, entrada y salida. Una cifra sin esas condiciones no permite comparar dos equipos de forma fiable.
Cuándo 128 GB son la ventaja decisiva
En palabras sencillas
La memoria es el tamaño de la mesa de trabajo, y el modelo debe estar entero encima para trabajar. Una gráfica de 32 GB tiene una mesa excelente pero pequeña; este equipo tiene una mesa de 128 GB. Ejemplo: el modelo abierto de 120B sencillamente no cabe en la gráfica — en el Spark trabaja a diario.
El modelo ya no cabe en VRAM
Modelos cuantizados grandes, contexto amplio, índices auxiliares y procesos simultáneos pueden necesitar bastante más de 32 o 48 GB. Spark permite mantener una porción mayor del trabajo en memoria coherente.
El modelo cabe con margen
Cuando pesos, caché KV y contexto caben íntegramente en una GPU rápida, su ancho de banda suele proporcionar menor latencia y mayor generación.
Necesitas CUDA y un entorno reproducible
DGX OS, contenedores y bibliotecas NVIDIA facilitan prototipos cercanos a una futura infraestructura de producción. Aun así, el despliegue final debe validarse; no es necesariamente idéntico.
Prioriza VRAM y el flujo concreto
Para ComfyUI, la resolución, el modelo, el lote y los nodos determinan la memoria. Una GPU discreta con suficiente VRAM puede ser más rápida que Spark.
Escala oficial
Bundle x2
Unidad
 Interconexión
Dos DGX Spark para modelos de hasta 405B
NVIDIA destaca la conexión de dos sistemas DGX Spark mediante ConnectX para trabajar con modelos de hasta 405.000 millones de parámetros. Esa cifra es la referencia explícita para una pareja. NVIDIA Sync también valida tres nodos en anillo y hasta cuatro mediante switch, pero no publica un límite universal de parámetros para esas topologías.
Más unidades pueden aportar capacidad de servicio mediante réplicas, colas y trabajos independientes. También pueden participar en un único modelo si el programa que ejecuta el modelo soporta paralelismo distribuido en esa topología. No es correcto sumar memorias o parámetros sin una receta probada.
Bundle x2Dos DGX Spark en una ficha
Opción comercial para adquirir la pareja. Confirma el contenido exacto del bundle y el cable QSFP necesario para la receta soportada.
Abrir el bundle x2UnidadDGX Spark Founders Edition
Consulta la configuración comercial y el precio cerrado en la ficha.
Abrir la fichaInterconexiónCable DAC QSFP
Enlace físico para el emparejamiento de dos unidades compatibles.
Abrir la ficha del cablePlanificación
Más capacidad de servicio
Para réplicas, colas y varios equipos, revisa la arquitectura de despliegue horizontal.
Ver clústeresDGX Spark frente a otras opciones
| Plataforma | Ventaja principal | Condición que debes validar |
|---|---|---|
| DGX Spark | 128 GB coherentes, CUDA y formato integrado | Ancho de banda inferior al de una GPU discreta rápida |
| ASUS Ascent GX10 | La misma base GB10 en otra configuración de fabricante | Almacenamiento, conexiones, soporte y canal concretos |
| RTX PRO 6000 96 GB | Gran ancho de banda y rendimiento de GPU profesional | El modelo completo y la caché deben caber en 96 GB |
| GPU de consumo | Alta velocidad en modelos que caben en VRAM | Capacidad de memoria, refrigeración y límites de uso |
| DGX Station | 748 GB coherentes y GB300 Blackwell Ultra | Proyecto, alimentación, operación y presupuesto de otra escala |
La comparación directa entre las dos implementaciones GB10 está en DGX Spark frente a ASUS Ascent GX10. Para una carga que supera claramente Spark, consulta el análisis de DGX Station.
Información técnica opcional: entorno reproducible, benchmarks y servicio interno
No necesitas esta parte para completar el tutorial básico. Ábrela únicamente si vas a administrar el sistema, compartirlo con más personas o resolver una incidencia.
De la caja a una estación de IA reproducible
La primera configuración debe producir un inventario, no solo una demostración. Registra referencia, firmware, versión de DGX OS, red, almacenamiento y usuarios. Después valida CUDA y una carga conocida antes de añadir aplicaciones de terceros.
- Revisa ubicación y alimentación. Deja ventilación y evita conectar periféricos o adaptadores no previstos durante el diagnóstico inicial.
- Completa la configuración del sistema. Crea una cuenta administrativa separada del uso diario y aplica las actualizaciones recomendadas.
- Configura red. Utiliza una dirección conocida, DNS y segmentación. No publiques servicios de modelo en Internet.
- Comprueba almacenamiento. Separa espacio para modelos, contenedores, datos y copias. Define un umbral de capacidad.
- Valida el entorno NVIDIA. Confirma que el sistema reconoce el acelerador y ejecuta un contenedor o ejemplo oficial.
- Prueba un modelo pequeño. Mide carga, prefill y generación, y verifica que el proceso utiliza la GPU.
- Versiona la configuración. Guarda sistema, programa que ejecuta el modelo, modelo, cuantización y resultados.
Arquitectura ARM64: DGX Spark utiliza una CPU Grace basada en ARM. El software debe disponer de paquetes o contenedores compatibles. Revisa binarios nativos y extensiones CUDA antes de dar por hecho que un entorno x86 se trasladará sin cambios.
Calcular qué aporta la memoria coherente a una carga concreta
La ventaja principal es la capacidad: CPU y GPU comparten 128 GB. Esto permite mantener pesos y contexto que superan la VRAM habitual. No significa que toda la memoria esté disponible para el modelo ni que tenga el mismo ancho de banda que una GPU discreta de gama alta.
| Carga | Qué consume memoria | Qué medir |
|---|---|---|
| Chat LLM | Pesos, caché KV y programa que ejecuta el modelo | Contexto máximo, TTFT y tokens/s |
| RAG | Modelo, contexto recuperado y sesiones | Prefill, calidad y usuarios simultáneos |
| Agente | Esquemas, historial y resultados de herramientas | Pasos, memoria por sesión y latencia total |
| Imagen | Checkpoint, VAE, latentes y nodos | Pico por resolución y tiempo por imagen |
| Fine-tuning ligero | Pesos, adaptadores, optimizador y activaciones | Lote, secuencia, tiempo y estabilidad |
Cuándo una GPU discreta sigue siendo preferible
Si el modelo y el contexto caben con margen en VRAM, una GPU discreta con mayor ancho de banda suele generar más rápido. Spark no sustituye automáticamente una estación RTX; resuelve otra frontera: capacidad local compacta con CUDA y un entorno integrado.
Cuándo Spark cambia la viabilidad
Cuando una variante necesita más memoria de la disponible en una GPU convencional, la alternativa suele ser descargar a RAM, cuantizar más, reducir contexto o pasar a infraestructura de mayor capacidad. Spark permite mantener una carga mayor dentro del espacio coherente y evita parte de esos compromisos.
Reducir incompatibilidades mediante entornos fijados
Utiliza contenedores o entornos virtuales por proyecto. Fija imagen, dependencias y modelo. No instales bibliotecas globales para cada prueba; un cambio de CUDA, PyTorch o extensión puede romper otras cargas.
- Imagen o entorno por aplicación
- Compatibilidad ARM64 comprobada
- Versiones de CUDA y framework registradas
- Modelos y datasets fuera de la capa del contenedor
- Secretos mediante variables protegidas o gestor
- Puertos ligados a localhost o red interna
- Prueba de actualización y reversión
Para Ollama, confirma que el modelo es local, la ventana efectiva y el procesador mediante ollama ps. Para Open WebUI, deja Ollama en una red interna. Para ComfyUI, separa modelos y nodos personalizados y registra snapshots.
Crear una ficha de benchmark que se pueda comparar
Las cifras publicadas solo son útiles si indican modelo, precisión, motor, contexto y versión. Prefill y generación son fases distintas. Una optimización puede acelerar una de ellas sin cambiar la otra.
- Descarga una variante identificable y registra su tamaño.
- Reinicia o libera memoria para medir carga en frío.
- Ejecuta un prompt corto y otro con el contexto objetivo.
- Conserva número de tokens de entrada y salida.
- Registra tiempo de carga, prefill, generación y total.
- Repite con el modelo residente y calcula variación.
- Añade sesiones concurrentes y percentiles.
- Comprueba memoria, temperatura y errores durante una prueba sostenida.
Ficha mínima
- equipo y versión de sistema
- motor y versión
- familia, variante y cuantización
- contexto solicitado y efectivo
- tokens de entrada y salida
- tiempo de carga
- tokens/s de prefill y generación
- pico de memoria
- concurrencia y percentil de latencia
No compares el petaFLOP FP4 con FLOPS FP64 científicos. Son precisiones y cargas diferentes. Para una compra, compara el trabajo real que debe terminar el equipo.
Preparar el emparejamiento para modelos de hasta 405B
NVIDIA destaca el enlace de dos DGX Spark mediante ConnectX para cargas distribuidas y modelos de hasta 405B. Necesitas dos sistemas compatibles, un cable DAC QSFP adecuado y software que reparta el modelo. No es una suma automática para cualquier aplicación.
Enlace directo
Comprueba referencia, longitud, puertos y topología. La ficha del cable QSFP para DGX Spark cierra el componente físico.
Motor distribuido
Alinea sistema, contenedor, pesos y configuración en ambos nodos. Utiliza una receta compatible y mide comunicación.
Para una pyme, más de dos unidades suelen ser más sencillas de operar como réplicas, colas, embeddings, lotes o modelos por función. NVIDIA también valida tres nodos en anillo y hasta cuatro mediante un switch compatible; repartir un único modelo entre ellos exige un programa que ejecuta el modelo distribuido, una topología soportada y pruebas de recuperación. La guía de clústeres de DGX Spark separa ambos escenarios.
Convertir Spark en un servicio interno sin exponer la consola
Usuarios → HTTPS / SSO → aplicación → cola → servidor de modelo
                                      ↘ métricas y límites
- Identidad y autorización en la aplicación
- Ollama o programa que ejecuta el modelo accesible solo desde red interna
- Cuotas de contexto, salida y concurrencia
- Modelos permitidos y versiones fijadas
- Separación entre chat, lotes y tareas de entrenamiento
- Registro proporcional sin prompts completos por defecto
- Copias de configuración, índices y datos autorizados
- Plan de mantenimiento y continuidad
Un único Spark puede servir a varias personas si el modelo y la latencia lo permiten. Cuando el problema es cola, añade réplicas o separa cargas; un modelo más grande puede empeorar el servicio.
Datos que convierten una consulta comercial en una recomendación técnica
| Dato | Ejemplo de precisión necesaria |
|---|---|
| Modelo | Familia, tamaño, cuantización y formato |
| Contexto | Prompt, documentos, historial y máximo real |
| Usuarios | Simultáneos, pico y tolerancia de cola |
| Aplicación | Ollama, RAG, agentes, ComfyUI o desarrollo CUDA |
| Rendimiento | Tiempo hasta respuesta y duración total |
| Datos | Ubicación, privacidad, tamaño y actualizaciones |
| Operación | Estación individual o servicio administrado |
Referencia disponible
Ver la ficha de DGX SparkNVIDIA DGX Spark Founders Edition
Consulta la referencia exacta y el precio cerrado en la ficha. Para validar el encaje, adjunta modelo, contexto y usuarios.
Una compra técnica requiere una carga concreta
Indica familia de modelo, cuantización, longitud de contexto, número de usuarios y herramientas previstas. Con esos datos se puede decidir entre una GPU, Spark, dos Spark o una estación de mayor capacidad.
Contacto y compraLas reglas de conexión · ¿1, 2, 3 o 4 nodos?
- Dos nodos: mantienen la referencia oficial de hasta 405B con software compatible y un enlace QSFP directo.
- Tres o cuatro nodos: NVIDIA Sync valida un anillo de tres y topologías de hasta cuatro mediante switch; repartir un modelo exige un programa que ejecuta el modelo compatible y pruebas reales.
- Más usuarios: si el modelo cabe en una unidad, suele ser más sencillo añadir réplicas o colas que dividir el modelo. Ver topologías y límites →
Fuentes técnicas y criterio editorial
Las especificaciones, funciones y límites descritos se contrastan con documentación primaria de NVIDIA DGX Spark y clústeres. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Ficha oficial de DGX Spark · Hardware de DGX Spark · Topologías validadas de dos a cuatro nodos · Benchmarks publicados por NVIDIA
Respuestas directas
¿Cuántos parámetros admite un DGX Spark?
NVIDIA posiciona una unidad para modelos de hasta 200.000 millones de parámetros. Dos unidades conectadas oficialmente amplían la capacidad hasta modelos de 405.000 millones, siempre que el formato, la precisión y el software utilizado sean compatibles.
¿Un DGX Spark es más rápido que una GPU de sobremesa?
No necesariamente. Una GPU discreta puede generar más rápido cuando el modelo cabe en su VRAM. DGX Spark aporta 128 GB de memoria unificada y empieza a ser especialmente útil cuando el modelo, el contexto o la concurrencia superan esa VRAM.
¿El petaFLOP FP4 equivale al rendimiento científico FP64?
No. La cifra anunciada corresponde a operaciones de IA en FP4 y con las condiciones indicadas por el fabricante. No debe compararse con FLOPS FP64 de cálculo científico.
¿Ollama viene instalado de fábrica?
DGX Spark incorpora DGX OS y el ecosistema de software de NVIDIA. Ollama puede instalarse y utilizarse en el equipo, pero no debe presentarse como una aplicación garantizada de fábrica en todas las imágenes del sistema.
¿Se pueden unir más de dos unidades para un único modelo?
NVIDIA cita hasta 405B para una pareja y NVIDIA Sync valida topologías de tres nodos en anillo y de hasta cuatro nodos mediante switch. Un único modelo solo puede repartirse si el programa que ejecuta el modelo y la carga soportan esa topología; la memoria no se fusiona de forma transparente.
¿Dónde se consulta el precio?
El importe actualizado y las condiciones comerciales se muestran en la ficha de DGX Spark en tienda.ietres, con precio cerrado en la ficha.