Antes de empezar
- Una GPU compatible o un equipo para hacer la prueba
- Espacio para los modelos
- Una imagen objetivo o un estilo que quieras reproducir
AI Supercomputers es el portal de IA local del grupo ietres.La compra se realiza en nuestras tiendas oficiales. Si una referencia no aparece con stock, consulta la posibilidad de reserva y la siguiente entrada prevista.
ComfyUI convierte la generación en un grafo reproducible: cada nodo carga un modelo, transforma datos o controla una etapa. Esa flexibilidad exige gestionar memoria, dependencias y nodos personalizados como componentes de software.
Al terminar tendrás un flujo básico de texto a imagen guardado y sabrás qué parte consume memoria de la GPU.
No necesitas entender toda la parte técnica para comenzar. Sigue el recorrido básico y abre los apartados avanzados únicamente cuando la primera prueba funcione.
No necesitas una biblioteca de nodos ni automatización desde el primer día. Elige un flujo de trabajo conocido, fija resolución y modelo, genera varias muestras y comprueba cuánto tarda y cuánta VRAM consume.
Un flujo de trabajo, un modelo, una resolución y una carpeta de resultados.
Prioriza GPU y VRAM cuando la espera, la resolución o el vídeo sean el límite.
Nodos personalizados, colas, API, varios usuarios y automatización por lotes.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
Una GPU compatible, drivers revisados, espacio para modelos y un flujo de trabajo de referencia.
Ejecutar un flujo reproducible, identificar el consumo de VRAM y separar nodos confiables de extensiones no revisadas.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →En cargas visuales se prioriza VRAM y velocidad de GPU; GB10 entra cuando el flujo de trabajo necesita más capacidad.
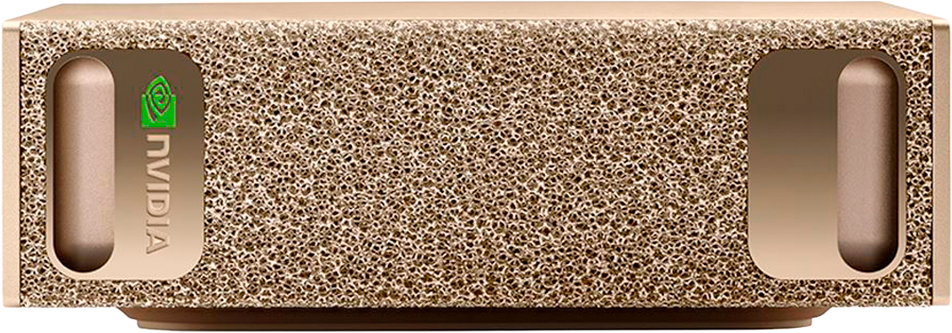
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
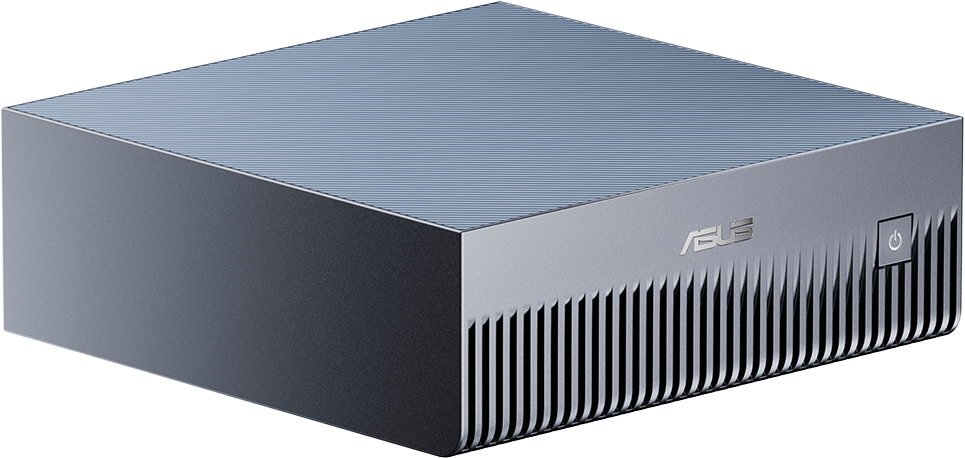
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
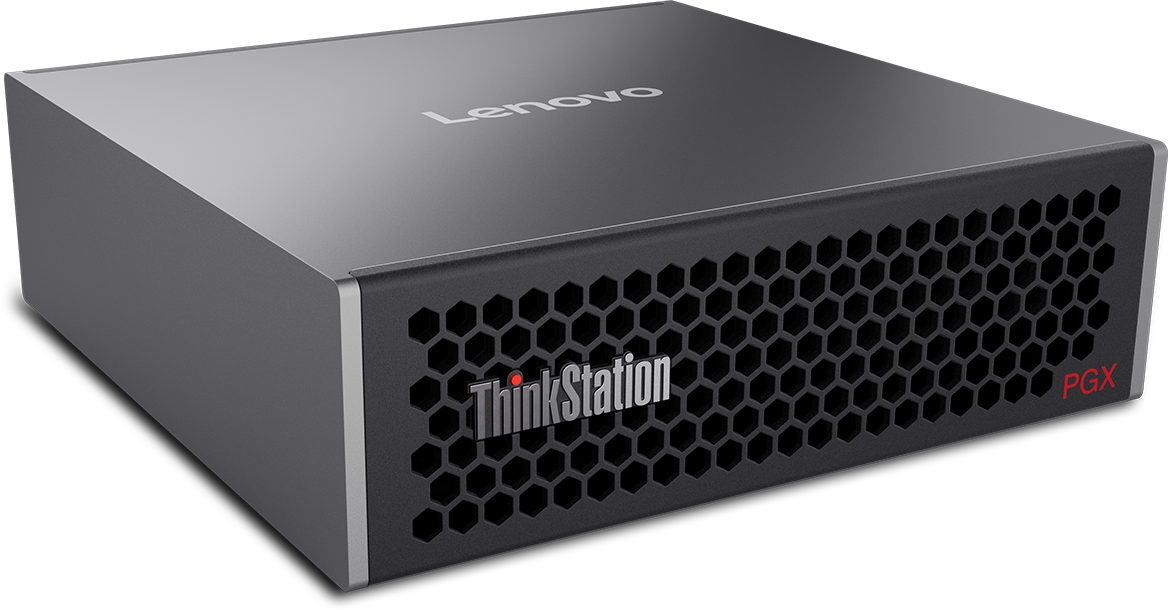
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
ComfyUI se maneja como una receta hecha de cajitas conectadas: una caja carga el modelo, otra recibe tu descripción, otra genera la imagen. El primer día impone; al tercero se agradece, porque la receta queda guardada y se repite idéntica con un clic. Ejemplo real: la "receta" de fotos de producto de una tienda se ejecuta cada semana con artículos nuevos sin reconfigurar nada.
En ComfyUI, un flujo enlaza nodos para cargar checkpoints, codificar texto, generar latentes, aplicar control, decodificar y guardar resultados. El usuario puede inspeccionar la ruta de datos, reutilizar partes y fijar parámetros. Esto facilita reproducibilidad y automatización.
La documentación oficial incluye plantillas con nodos del núcleo y permite instalar en Windows, macOS y Linux. También existe un ecosistema amplio de nodos personalizados. Conviene empezar con plantillas del núcleo porque reducen dependencias y simplifican el diagnóstico.
ComfyUI puede producir imagen, vídeo, audio, objetos tridimensionales y otros medios según los modelos y nodos disponibles. No todas las funciones son locales: ciertos nodos de socios o APIs pueden enviar datos a servicios externos.
El checkpoint no es el único consumidor de memoria. Text encoders, VAE, ControlNet, adaptadores, modelos de vídeo, cachés y lotes pueden coincidir en GPU. Algunos nodos descargan componentes a RAM, lo que reduce memoria de GPU a cambio de tiempo.
Un flujo guardado debe conservar también sus modelos, versiones y nodos. La imagen generada puede contener metadatos del flujo, pero no reemplaza un inventario de producción.
Instalación guiada y entorno separado. Adecuada para usuarios que quieren reducir tareas manuales.
Útil para una instalación autocontenida en hardware compatible, con actualizaciones controladas.
Permite fijar dependencias, automatizar y administrar servidores, pero exige más mantenimiento.
La instalación manual oficial recomienda un entorno virtual para no contaminar el Python del sistema. En producción, fija versiones y conserva el archivo de dependencias. Una actualización de ComfyUI puede requerir actualizar paquetes.
La memoria necesaria depende de checkpoint, precisión, resolución, lote, número de fotogramas, atención, ControlNet, adaptadores y nodos. Dos flujos con la misma resolución pueden tener requisitos muy distintos.
| Cambio | Efecto habitual | Qué medir |
|---|---|---|
| Más resolución | Aumenta tensores y atención | Pico de VRAM y tiempo por imagen |
| Más lote | Mejora rendimiento total, consume más memoria | Imágenes por minuto y latencia individual |
| Vídeo | Añade dimensión temporal y modelos grandes | VRAM, RAM, almacenamiento y duración |
| ControlNet y adaptadores | Cargan redes auxiliares | Memoria simultánea y descarga a CPU |
| Cuantización | Reduce pesos con impacto variable | Calidad, compatibilidad y velocidad |
| Offload | Reduce VRAM, aumenta transferencias | Tiempo total y uso de RAM |
Para un flujo que cabe en una GPU rápida, su ancho de banda suele ofrecer mejor rendimiento. La RTX PRO 6000 de 96 GB es una opción profesional. DGX Spark aporta 128 GB coherentes cuando la capacidad pesa más, pero necesita una prueba controlada.
ComfyUI representa los flujos como JSON. Para una llamada programática se utiliza un formato API específico, distinto del formato visual de guardado. Exporta el flujo para API y trata los identificadores de nodo y entradas como un contrato versionado.
Aplicación → valida parámetros → construye workflow API → envía a ComfyUI
           → consulta estado → recoge salida → registra modelo y versión
No permitas que un usuario modifique arbitrariamente rutas de archivo, nodos o URLs. Crea una plantilla permitida y expón solo parámetros controlados como prompt, semilla, resolución dentro de límites y número de resultados.
No necesitas esta parte para completar el tutorial básico. Ábrela únicamente si vas a administrar el sistema, compartirlo con más personas o resolver una incidencia.
ComfyUI es una interfaz por nodos y, al mismo tiempo, un motor de ejecución. La aplicación ocupa poco en comparación con los pesos: checkpoints, VAE, LoRA, ControlNet, modelos de texto, upscalers y modelos de vídeo son archivos independientes. Antes de instalar, separa tres ubicaciones: aplicación, modelos y resultados. Esa decisión simplifica copias, actualizaciones y recuperación.
Es la entrada más sencilla para una estación personal. Gestiona la aplicación y reduce la fricción inicial. Resulta adecuada para aprender nodos, importar plantillas y validar un flujo antes de automatizarlo.
Permite mantener ComfyUI en una carpeta autocontenida. Conviene colocar modelos y salidas fuera de la carpeta de la aplicación para que una actualización o una copia no mezcle código, pesos y trabajos.
Es la opción apropiada cuando necesitas fijar versiones, automatizar el arranque, separar usuarios o integrar la API. Utiliza un entorno virtual y registra el commit o la versión desplegada.
Regla de mantenimiento: una instalación estable no se actualiza durante un trabajo crítico. Primero se clona o se crea un entorno de ensayo, se abre una copia del flujo y se compara el resultado.
En muchos flujo de trabajos, CLIP o el codificador de texto transforma el prompt en representaciones que el modelo utiliza durante el muestreo. Según la arquitectura puede venir dentro del checkpoint o como archivo separado; no intercambies codificadores sin comprobar compatibilidad.
Utiliza nombres internos coherentes y conserva una ficha por flujo. Debe indicar procedencia y licencia de cada peso, hash o identificador, ubicación, finalidad, versión de ComfyUI, nodos personalizados y una salida esperada. Si el mismo repositorio de modelos se comparte entre instalaciones, configura rutas adicionales en lugar de duplicar cientos de gigabytes.
| Componente | Carpeta habitual | Comprobación |
|---|---|---|
| Checkpoint | models/checkpoints | Aparece en el nodo de carga y coincide con la arquitectura del flujo |
| VAE | models/vae | Decodifica sin dominantes de color ni dimensiones inesperadas |
| LoRA | models/loras | El nodo lo encuentra y la intensidad produce un cambio controlado |
| ControlNet | models/controlnet | Preprocesador, tipo de control y modelo corresponden entre sí |
| Upscaler | models/upscale_models | Factor y memoria se miden con una imagen representativa |
| Entradas y salidas | input y output | Permisos, cuota, retención y nombres no exponen datos sensibles |
El flujo mínimo sirve para comprender dónde se carga el modelo y dónde aumenta la memoria. No empieces con una plantilla de decenas de nodos. Crea una cadena que puedas explicar de izquierda a derecha.
Checkpoint → Modelo ───────────────┐
             Texto positivo ──────┤
             Texto negativo ──────┤→ Sampler → VAE Decode → Guardar
Latente vacío ────────────────────┘
Guarda el flujo de trabajo en JSON y conserva una imagen con metadatos cuando el formato lo permita. Anota modelo, hash, VAE, LoRA, intensidades, resolución, lote, pasos, sampler, scheduler, guía, semilla y versión de cada nodo personalizado. Una misma semilla no garantiza el mismo resultado si cambia cualquiera de esos elementos.
Fija prompt, semilla, resolución y modelo. Cambia una sola variable. Registra tiempo total, pico de memoria, errores, calidad visual y consistencia. Para vídeo o lotes, añade fotogramas, duración y tiempo por unidad. No elijas hardware por una captura aislada: utiliza el flujo de trabajo más exigente que esperas mantener.
El consumo no depende únicamente del checkpoint. Resolución, lote, precisión, atención, VAE, ControlNet, upscaling, vídeo y nodos auxiliares compiten por memoria. Cuando falta VRAM, ComfyUI puede descargar componentes a RAM o ejecutar modos de bajo consumo; el flujo quizá termine, pero con una latencia muy superior.
| Síntoma | Causa probable | Orden de actuación |
|---|---|---|
| Error de memoria al comenzar | Pesos y componentes no caben | Cierra otros procesos, confirma precisión, reduce componentes y prueba un modelo menor |
| Falla al decodificar | Pico del VAE a alta resolución | Usa decodificación por teselas si es compatible o reduce resolución de esa fase |
| Primera imagen correcta y lote posterior falla | Memoria retenida, lote o nodo con fuga | Reinicia, prueba el núcleo, reduce lote y aísla el nodo añadido |
| GPU con baja utilización y proceso muy lento | Descarga a CPU, lectura de disco o nodo no acelerado | Revisa consola, memoria, almacenamiento y dispositivo de cada componente |
| Resultado distinto tras actualizar | Cambio de nodo, modelo o algoritmo | Restaura snapshot y compara con el flujo y los hashes registrados |
Un nodo personalizado ejecuta código con los permisos del proceso de ComfyUI. Puede instalar dependencias, leer archivos, abrir conexiones y modificar resultados. El hecho de aparecer en un flujo de trabajo compartido no constituye una revisión de seguridad.
No importes y ejecutes un flujo de trabajo desconocido de inmediato. Revisa nodos ausentes, modelos solicitados, rutas de archivo y cualquier bloque que llame a servicios externos. La interfaz visual no muestra por sí sola todo lo que hace el código.
ComfyUI puede recibir flujo de trabajos en formato API, encolarlos y devolver identificadores de ejecución. El JSON para API no debe confundirse con el archivo de edición normal. Exporta el formato correcto, identifica los campos que la aplicación podrá cambiar y valida cada entrada antes de enviarla.
En un servicio compartido, coloca ComfyUI detrás de una aplicación que aporte autenticación, autorización, límites y registro. No publiques el puerto de la interfaz directamente en Internet.
Para recomendar una estación necesitamos checkpoint, precisión, resolución, lote, ControlNet, VAE, upscaler, vídeo, número de trabajos simultáneos y tiempo objetivo. Con esos datos se compara una GPU rápida, una RTX PRO de gran VRAM o una plataforma de memoria unificada.
Modelo, resolución, lote, nodos auxiliares y número de trabajos simultáneos definen el hardware. Una tabla genérica de VRAM no sustituye esa medición.
Abrir el recomendadorLas especificaciones, funciones y límites descritos se contrastan con documentación primaria de ComfyUI. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Es una aplicación de código abierto basada en nodos para construir y ejecutar flujos de IA generativa, especialmente de imagen, vídeo, audio y procesos multimodales.
No existe una cifra única. Depende de modelo, precisión, resolución, lote, atención, nodos, ControlNet, VAE y descarga a CPU. Debes probar el flujo exacto.
Son código de terceros y pueden ejecutar acciones con los permisos del proceso. Revisa repositorio, dependencias y mantenedor, utiliza entornos aislados y no instales paquetes sin evaluación.
Sí. Los flujos se representan como grafos y existe un formato API en JSON para enviarlos al servidor local. El formato de API difiere del guardado normal del navegador.
No. Tiene instalación local y autoalojada. Algunas funciones o nodos de socios pueden utilizar servicios externos; revisa cada nodo y bloquea salidas no autorizadas.
No. Una GPU discreta con suficiente VRAM suele ser más rápida por su ancho de banda. Spark aporta capacidad cuando el flujo supera la VRAM, pero debe medirse con el modelo y la resolución reales.