Antes de empezar
- LM Studio instalado
- Espacio de disco suficiente
- Una pregunta real para comparar respuestas
AI Supercomputers es el portal de IA local del grupo ietres.La compra se realiza en nuestras tiendas oficiales. Si una referencia no aparece con stock, consulta la posibilidad de reserva y la siguiente entrada prevista.
LM Studio reúne descarga de modelos, chat, documentos y un servidor de API en una aplicación de escritorio. Es una vía cómoda para evaluar IA local, siempre que se controle la variante, la memoria y cualquier exposición a la red.
Al terminar habrás descargado un modelo, conversado con él y comparado dos variantes sin utilizar la terminal.
No necesitas entender toda la parte técnica para comenzar. Sigue el recorrido básico y abre los apartados avanzados únicamente cuando la primera prueba funcione.
Instala la aplicación, descarga un modelo pequeño y prueba una tarea real. Para un servicio compartido con usuarios y permisos, la ruta habitual pasa después por un motor y una interfaz de equipo.
Chat local de una persona, modelos pequeños y documentos de prueba.
Más hardware cuando el modelo útil no quepa o la generación sea demasiado lenta.
Servidor compartido, identidad, copias y operación multiusuario.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
Un equipo con memoria suficiente y un caso de prueba que permita comparar modelos.
Cargar un modelo, medirlo y exponer una API local sin confundir una prueba de escritorio con un servicio empresarial.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →La interfaz no elimina el límite de memoria: mide pesos, contexto y velocidad antes de elegir.
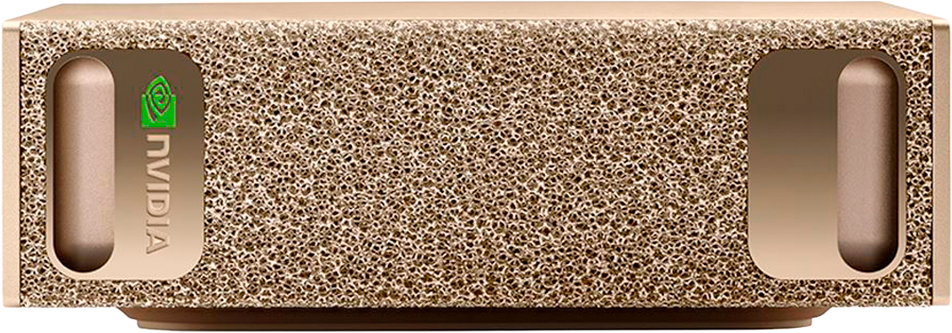
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
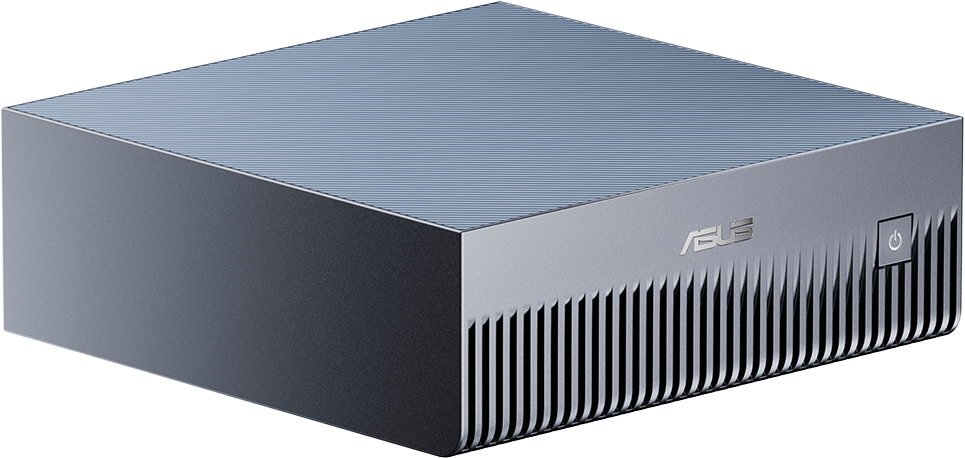
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
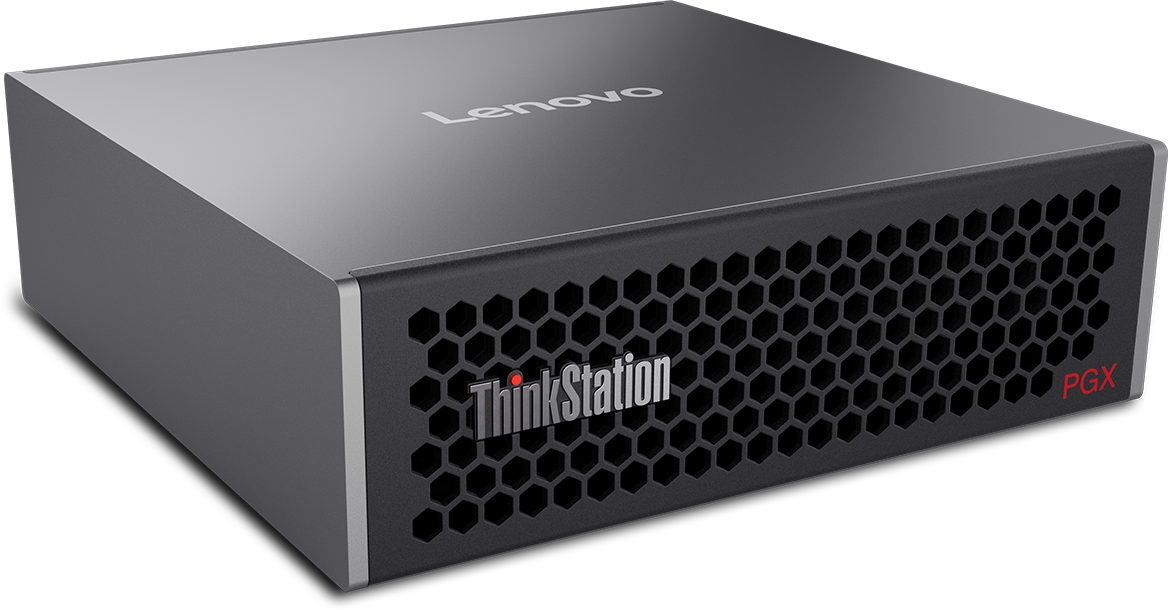
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
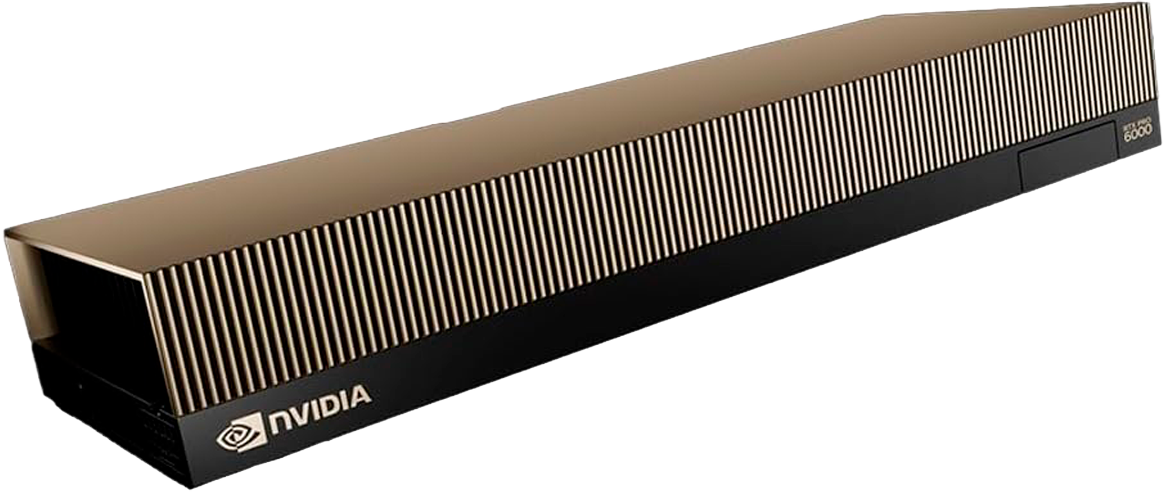
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
LM Studio es la versión "con ventanas y botones" de la IA local: todo con ratón — buscar el modelo, descargarlo, conversar — sin escribir un solo comando. Ideal para la primera semana y para quien no quiere terminal; cuando toque servir la IA a más personas, el relevo natural es Ollama.
LM Studio permite buscar y descargar modelos, cargar una variante cuantizada, conversar, adjuntar documentos y levantar un servidor local. Para una persona que empieza, concentra varias tareas en una interfaz. Para desarrollo, expone APIs y herramientas de línea de comandos.
Puede operar completamente sin conexión una vez que la aplicación, los modelos y los recursos necesarios están disponibles. Esto incluye chat, conversación con documentos y servidor local. La privacidad efectiva depende además de no activar integraciones externas y de proteger los archivos, el historial y la red.
LM Studio no debe describirse como un proyecto de código abierto de forma general. Sus condiciones vigentes permiten uso personal e interno de empresa; revisa siempre las condiciones de la aplicación y la licencia de los pesos que descargues.
Desde el área de desarrollo, LM Studio puede iniciar un servidor en el propio equipo. También dispone de comandos para arrancarlo y definir puerto. Mantén el enlace en 127.0.0.1 durante las pruebas.
lms server start --port 1234
LM Studio ofrece endpoints compatibles con OpenAI y Anthropic, además de sus propias bibliotecas. «Compatible» no significa que todas las operaciones, esquemas de herramientas, eventos de streaming o códigos de error sean idénticos. Crea pruebas de contrato para la integración.
curl http://127.0.0.1:1234/v1/models
Si necesitas acceso desde la red, la documentación permite enlazar a otra dirección, pero recomienda habilitar autenticación. Añade además TLS mediante una capa frontal, segmentación, límites de entrada y reglas de cortafuegos.
La función de documentos es útil para pruebas individuales. En una empresa hay que distinguir una conversación con archivos de un sistema RAG con permisos, versionado, eliminación, evaluación y fuentes. Un documento cargado por un usuario no debería quedar disponible para otro por defecto.
Comprueba extracción, fragmentación, respuesta y citas antes de ampliar.
Utiliza una arquitectura con autorización previa a la recuperación, inventario y borrado propagado. Consulta RAG para empresa.
| Herramienta | Punto fuerte | Uso habitual |
|---|---|---|
| LM Studio | Aplicación gráfica y servidor local en el puesto | Evaluación, demostraciones y desarrollo individual |
| Ollama | Servicio, terminal, gestión sencilla e integraciones | Backends locales, automatización y despliegues compactos |
| Open WebUI | Interfaz web, usuarios, permisos y conocimiento compartido | Acceso de equipos sobre Ollama u otros proveedores |
Las tres herramientas pueden convivir, pero evita duplicar repositorios y modelos sin control. Define cuál gestiona los pesos, cuál expone la API y cuál conserva conversaciones.
LM Studio está pensado para explorar modelos desde una aplicación gráfica, pero la facilidad de uso no elimina las decisiones técnicas. La primera sesión debe dejar registrados el sistema, la memoria disponible, la variante exacta, el backend, el contexto y los parámetros. Así podrás repetir el resultado y distinguir una mejora real de un cambio de configuración.
El tamaño del archivo orienta, pero la memoria de ejecución incluye estructura, contexto y buffers. Compara Q4, Q6 o Q8 con la misma tarea si la calidad es crítica.
Si el modelo no cabe en el acelerador, parte de la carga puede desplazarse a memoria del sistema. Esto amplía capacidad, pero suele aumentar mucho la latencia.
No selecciones el máximo anunciado por defecto. Elige la ventana mínima que cubra tu caso y mide cómo cambia la memoria.
El buscador facilita acceder a repositorios de modelos, pero una lista ordenada por popularidad no equivale a una recomendación para tu empresa. Define primero idioma, tarea, longitud de contexto, necesidad de visión o herramientas y licencia aceptable.
| Filtro | Pregunta correcta | Qué registrar |
|---|---|---|
| Familia | ¿Está orientada a chat, razonamiento, código, visión o embeddings? | Nombre de familia y proveedor |
| Tamaño | ¿Cabe con margen junto al contexto y al sistema? | Parámetros y tamaño de archivo |
| Cuantización | ¿La reducción de memoria mantiene la calidad exigida? | Formato exacto y resultado de evaluación |
| Contexto | ¿El programa que ejecuta el modelo y el modelo sostienen la ventana que utilizarás? | Valor cargado y memoria durante la prueba |
| Licencia | ¿Permite tu uso, distribución y tratamiento previsto? | Texto y versión revisados internamente |
| Procedencia | ¿El repositorio y el archivo corresponden al modelo esperado? | Autor, hash o identificador disponible |
Para una selección más amplia por familias y memoria, consulta la guía de modelos de IA local.
La conversación con documentos permite validar si un modelo entiende tu tipo de contenido. El procedimiento correcto comprueba extracción, fragmentación, recuperación, citas y rechazo. Si la aplicación responde bien a un documento pequeño, todavía falta resolver permisos, versiones, borrado y aislamiento entre usuarios.
Un usuario, pocos archivos, finalidad de prueba, contenido no sensible y eliminación manual controlada.
Múltiples usuarios, repositorio vivo, permisos por documento, auditoría, fuentes y derechos. En ese caso utiliza el patrón descrito en RAG para empresa.
El documento también es entrada no confiable. Puede contener instrucciones dirigidas al modelo. Trátalo como datos, no como autoridad, especialmente si la respuesta puede activar herramientas.
LM Studio puede servir modelos desde la pestaña de desarrollo o mediante la CLI lms. El servidor local suele escuchar en el puerto 1234. Mantén la interfaz en localhost para las primeras pruebas y solo amplía el acceso cuando exista una capa de seguridad definida.
lms server start --port 1234
curl http://127.0.0.1:1234/v1/models
curl http://127.0.0.1:1234/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<identificador-visible-en-v1-models>",
    "messages": [
      {"role": "system", "content": "Responde con precisión."},
      {"role": "user", "content": "Explica el resultado de la prueba."}
    ],
    "temperature": 0.2
  }'
La respuesta puede incluir métricas de tiempo hasta el primer token y tokens por segundo según el endpoint. Registra además si el modelo estaba cargado. Una primera petición no es comparable con otra que reutiliza pesos residentes.
API compatible no significa idéntica. Valida los campos que utiliza tu aplicación, los formatos de error y el comportamiento ante herramientas. La compatibilidad parcial es suficiente para muchas integraciones, pero debe probarse.
| Caso | Elección inicial | Motivo |
|---|---|---|
| Comparar modelos desde un puesto | LM Studio | Interfaz gráfica, descarga, parámetros y métricas en un solo lugar |
| Ejecutar un backend compacto | Ollama | Servicio sencillo, CLI, API e integración con automatizaciones |
| Dar chat a varios usuarios | Open WebUI sobre un proveedor | Identidad, roles, historial, conocimiento y administración |
| Integrar una aplicación propia | LM Studio u Ollama | Depende del contrato de API, programa que ejecuta el modelo, operación y plataforma |
| RAG con permisos empresariales | Arquitectura dedicada | La interfaz por sí sola no resuelve autorización previa a la recuperación |
| Automatización de procesos | Ollama o API de LM Studio más orquestador | El orquestador controla herramientas, reintentos, permisos y aprobación |
No ejecutes varios gestores de modelos por inercia. Puedes duplicar almacenamiento, cargar dos copias del mismo modelo y crear conflictos de puertos. Define cuál es la fuente de inferencia de cada aplicación.
| Síntoma | Qué comprobar | Qué cambiar |
|---|---|---|
| El modelo no carga | Memoria estimada, formato y programa que ejecuta el modelo | Elige una cuantización menor o reduce contexto |
| La GPU no se utiliza | Backend, controlador y offload | Selecciona el programa que ejecuta el modelo compatible y confirma memoria libre |
| Primera respuesta muy lenta | Tiempo de carga del modelo | Mantén el modelo residente si la memoria lo permite |
| Las siguientes respuestas empeoran | Historial, contexto y caché | Recorta contexto y reinicia una conversación limpia |
/v1/models no responde | Servidor iniciado, puerto y dirección | Arranca el servidor y prueba desde localhost |
| Otra máquina no conecta | Enlace, cortafuegos y autenticación | No abras el puerto sin proxy, TLS y control de origen |
| JSON no cumple el esquema | Modelo, prompt y validación | Solicita salida estructurada y valida de nuevo en código |
| Un documento produce respuestas falsas | Extracción, fragmentos y recuperación | Prueba preguntas con fuente y separa problema de RAG y generación |
LM Studio es especialmente útil para descubrir la carga real. Si el modelo aprobado cabe en la VRAM de una GPU, esa GPU suele ofrecer la mejor velocidad. Si necesita más memoria, DGX Spark amplía la capacidad hasta 128 GB coherentes con CUDA. Para cargas que caben en 96 GB y buscan alto rendimiento, RTX PRO 6000 es la alternativa profesional.
Relaciona tarea, usuarios, privacidad y nivel de inversión para descartar opciones que no encajan.
Abrir el recomendador128 GB coherentesPara modelos y contextos que superan la VRAM convencional y necesitan un entorno NVIDIA integrado.
Ver ficha y precio cerrado96 GB GDDR7Para acelerar inferencia y creación cuando el conjunto de pesos y contexto cabe en la VRAM disponible.
Abrir la ficha profesionalPrueba varias familias con el mismo conjunto de tareas y conserva la variante más pequeña que cumpla calidad, contexto y licencia.
Elegir modelosLas especificaciones, funciones y límites descritos se contrastan con documentación primaria de LM Studio. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Documentación oficial de LM Studio · Servidor local de LM Studio
Sí. Después de descargar los modelos y dependencias necesarias, sus funciones principales de chat, documentos y servidor local pueden funcionar sin Internet.
No. LM Studio ofrece una aplicación gráfica, gestión de modelos y servidor local. Ollama está más orientado a servicio, terminal e integraciones. Pueden cubrir usos similares con experiencias distintas.
Sus condiciones vigentes permiten uso personal e interno de empresa. Debes revisar las condiciones, la licencia de cada modelo y las funciones que actives.
LM Studio ofrece endpoints compatibles, pero cada integración debe validarse. No presupongas paridad completa en todos los campos, herramientas y errores.
Solo con autenticación, TLS, cortafuegos, límites y segmentación. La propia documentación advierte que enlazar fuera de 127.0.0.1 expone el servidor.
Depende del modelo y de su cuantización. Como referencia práctica, conviene disponer de memoria suficiente para pesos, contexto y sistema, y de una GPU compatible cuando se busca mayor velocidad.