Antes de empezar
- Una tarea concreta
- Cinco ejemplos de entrada
- Una forma sencilla de decidir si la respuesta sirve
AI Supercomputers es el portal de IA local del grupo ietres.La compra se realiza en nuestras tiendas oficiales. Si una referencia no aparece con stock, consulta la posibilidad de reserva y la siguiente entrada prevista.
No elijas por popularidad ni por número de parámetros. Primero identifica la tarea: conversar, razonar, programar, analizar imágenes, buscar documentos, transcribir voz o generar audio.
Al terminar tendrás una lista corta de dos o tres modelos para comparar con ejemplos reales de tu trabajo.
No necesitas entender toda la parte técnica para comenzar. Sigue el recorrido básico y abre los apartados avanzados únicamente cuando la primera prueba funcione.
No empieces por el modelo con más parámetros. Compara dos o tres familias con ejemplos reales, en castellano y con el formato de salida que necesitas. Conserva el que cumple con menor coste de memoria y espera.
Una tarea, ejemplos reales y dos o tres modelos de distinto tamaño.
Hardware cuando ya sepas qué modelo funciona y cuánto contexto necesita.
Mezclas de expertos, servicio para varios usuarios avanzado y adaptación específica.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
Cinco o más ejemplos reales de entrada y la salida que considerarías correcta.
Crear una lista corta de familias y variantes que puedas comparar con las mismas pruebas.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →Compara una GPU rápida con 128 GB coherentes utilizando el mismo modelo, contexto y programa que ejecuta el modelo.
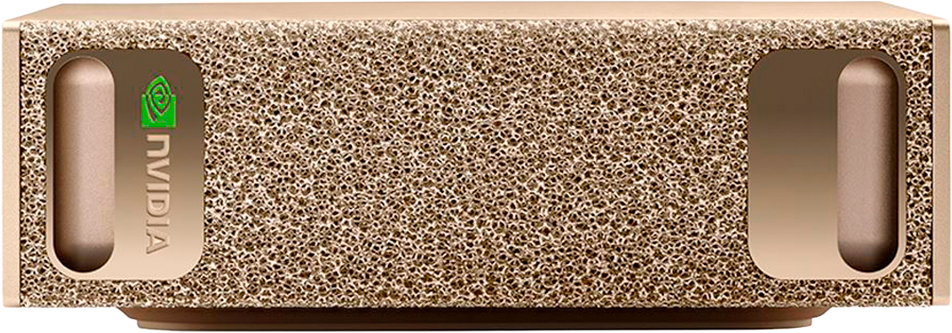
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
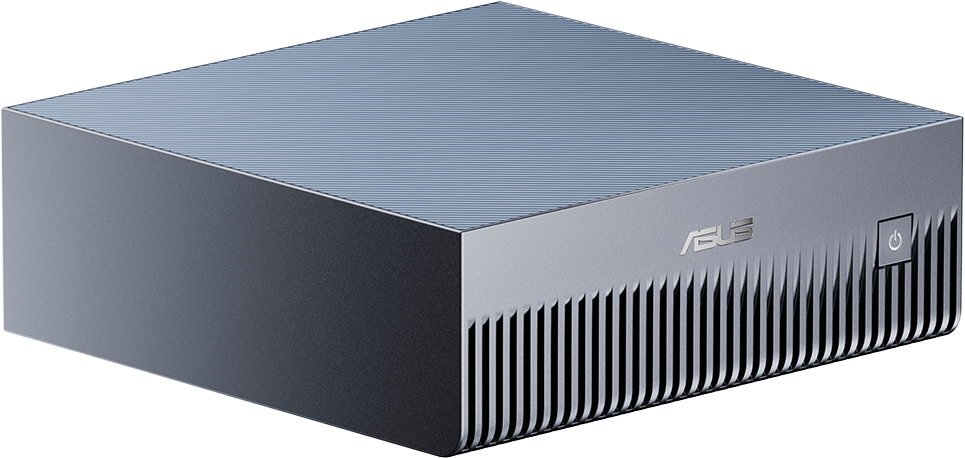
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
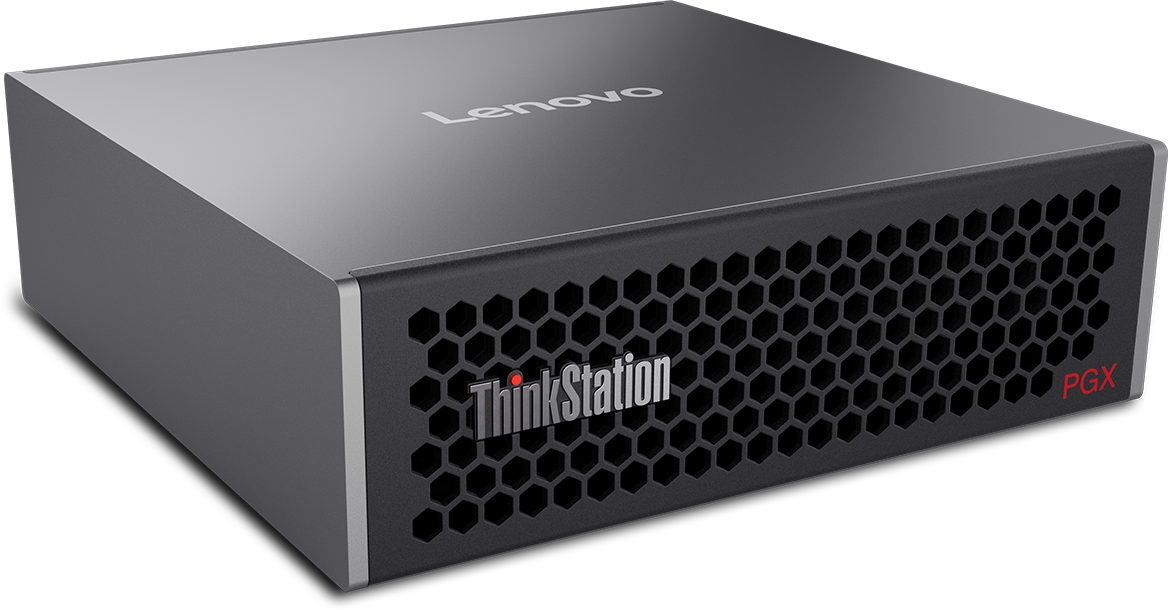
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
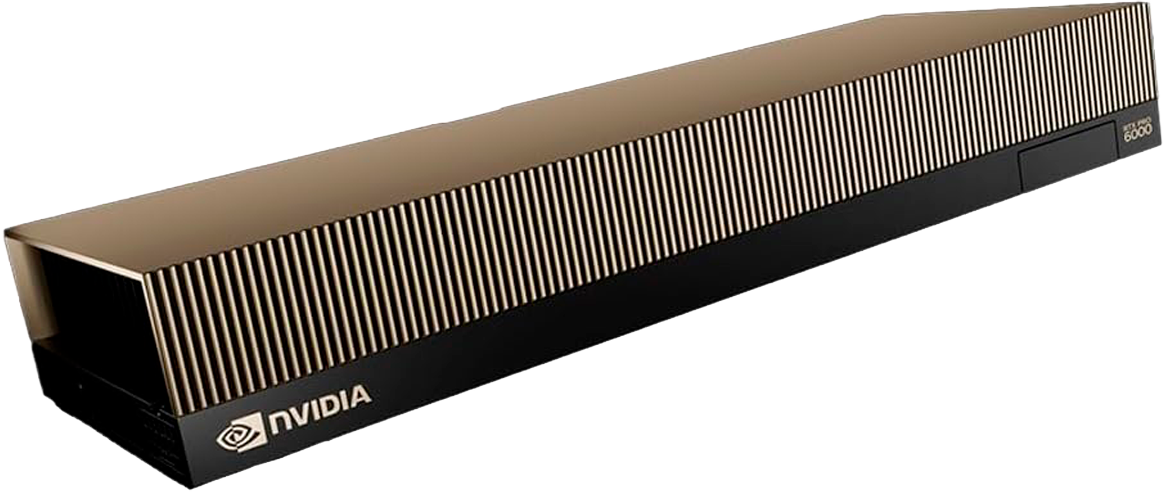
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
Qué es: familia general con variantes pequeñas, grandes y modos de razonamiento.
Úsala para: chat, redacción, castellano, herramientas, clasificación y código.
Empieza por: una variante pequeña o intermedia y sube solo si falla tu prueba.
Qué es: familia general orientada a diálogo y generación de texto.
Úsala para: asistentes, resumen, redacción y RAG.
Ten en cuenta: Llama 3.3 en Ollama es una variante 70B; no es el primer modelo para un equipo modesto.
Qué es: familia compacta de Google con variantes de texto y multimodales.
Úsala para: chat, resumen, razonamiento moderado y consultas con imágenes.
Empieza por: 4B o 12B para comparar calidad y memoria.
Qué es: familia de razonamiento con variantes destiladas y un modelo completo muy grande.
Úsala para: lógica, matemáticas, análisis y programación.
Empieza por: 8B, 14B o 32B; no dimensionar para 671B sin una necesidad demostrada.
Qué es: modelos abiertos orientados a razonamiento y uso de herramientas.
Úsala para: agentes controlados, análisis y tareas que requieren seguir un proceso.
Empieza por: 20B; la variante 120B exige mucha más memoria.
Qué es: familia especializada en código.
Úsala para: completar, explicar, corregir y generar pruebas.
No la uses sola para: ejecutar cambios sin revisión o acceder a secretos.
Qué son: modelos que convierten texto en vectores comparables.
Úsalos para: localizar documentos relevantes en un sistema RAG.
No hacen: conversar ni redactar la respuesta final.
Qué son: Whisper convierte audio en texto; Piper convierte texto en audio.
Úsalos para: actas, llamadas, citas y asistentes hablados.
Necesitan: un LLM y conectores de agenda o mensajería si quieres ejecutar acciones.
| Familia | Cuándo evaluarla | Qué debes comprobar |
|---|---|---|
| Qwen | Uso general, código, razonamiento, herramientas y escenarios multilingües | Tamaño, variante, contexto, licencia y calidad en castellano para tu dominio |
| Llama | Ecosistema amplio, integraciones, ejemplos y despliegues generales | Licencia de la variante, cuantización y comportamiento con herramientas |
| Gemma | Modelos eficientes, tareas generales y equipos con memoria limitada | Versión de la familia, formato y equilibrio entre tamaño y precisión |
| DeepSeek-R1 | Razonamiento y problemas que se benefician de más deliberación | Longitud de salida, latencia, memoria y necesidad de validación |
| gpt-oss | Razonamiento, herramientas y variantes de gran capacidad | Formato, motor optimizado, memoria y diferencias entre tamaños |
| Mistral | Uso general, despliegues compactos y familias con distintos perfiles | Licencia, idioma, contexto y soporte de la variante concreta |
La biblioteca cambia con frecuencia. Por eso el texto mantiene las familias y remite a ollama.com/library para etiquetas, tamaños y variantes actuales. No descargues una etiqueta solo por su nombre: abre su ficha y revisa memoria, cuantización, contexto y licencia.
Regla de bolsillo: cada 1.000 millones de parámetros (1B) ocupa alrededor de 0,6 GB en el formato habitual. Un 8B ronda los 5-6 GB (portátil normal); un 32B, unos 20 GB (gráfica grande); un 120B, unos 70 GB (equipo de 96-128 GB). Y la cuantización Q4 es como la calidad "alta" de una foto: la mitad de espacio con una diferencia casi imperceptible.
Una aproximación de los pesos es:
memoria de pesos ≈ parámetros × bits por peso ÷ 8
El resultado no incluye escalas de cuantización, metadatos, caché KV, buffers del motor, contexto, adaptadores, embeddings ni memoria del sistema. Para una compra, utiliza la variante real y añade margen.
| Escala orientativa | Pesos cuantizados aproximados | Plataforma habitual |
|---|---|---|
| Modelos compactos | En torno a 3–8 GB, según tamaño y formato | Equipo existente, portátil reciente o GPU modesta |
| Modelos medios | En torno a 8–24 GB | GPU con margen o memoria unificada |
| Modelos grandes | En torno a 40–90 GB | GPU profesional, Spark o memoria unificada amplia |
| Modelos muy grandes o MoE | Por encima de 100 GB en muchas variantes | DGX Spark, pareja de Spark o DGX Station, según formato |
Estas bandas son orientativas. Un modelo con menos pesos activos puede seguir necesitando almacenar muchos expertos, y una ventana de contexto amplia puede añadir una cantidad considerable de caché.
Evalúa instrucciones, castellano, consistencia, resumen y capacidad para reconocer incertidumbre.
Mide edición sobre archivos reales, pruebas, contexto del proyecto y uso seguro de herramientas.
Separa recuperación, relevancia de fragmentos, fidelidad y capacidad de abstenerse cuando falta evidencia.
Un razonamiento más largo no garantiza una respuesta correcta. Añade verificadores y criterios objetivos.
Comprueba formatos, resolución, OCR cuando corresponda y calidad con tus propios documentos.
La fiabilidad al devolver JSON o llamadas estructuradas puede importar más que una conversación general.
Para RAG, evalúa por separado el recuperador y el generador. Un modelo competente no puede citar un documento que el sistema no recupera. La arquitectura se explica en IA con los datos de tu empresa.
Una GPU discreta ofrece gran ancho de banda y suele ser la opción más rápida si pesos, contexto y caché caben en su VRAM. DGX Spark se vuelve relevante con modelos grandes, contexto amplio o varios componentes que requieren más de la VRAM habitual. Para una escala muy superior, DGX Station combina 252 GB HBM3e con 496 GB LPDDR5X.
Evita utilizar toda la memoria anunciada para los pesos. El sistema, el motor y la caché necesitan margen. En Ollama, ollama ps ayuda a comprobar si la carga está en GPU, parcialmente en CPU o completamente en CPU.
«Modelo» se utiliza para varias cosas distintas. Una familia define arquitectura y entrenamiento; una variante puede cambiar tamaño o capacidades; una cuantización modifica cómo se almacenan los pesos; el formato determina qué motor puede cargarlos; y la plantilla de chat condiciona cómo se presentan las instrucciones. Registrar solo un nombre corto impide reproducir una prueba.
En Ollama conviene consultar la biblioteca actual antes de descargar. Verifica tamaño, capacidades, licencia, contexto anunciado y etiquetas disponibles. Después confirma la ventana que realmente utiliza tu servidor: el máximo teórico del modelo no garantiza que la aplicación lo haya configurado.
Suele ofrecer variantes para conversación, razonamiento, código, visión y embeddings. Es una candidata frecuente para castellano y contextos técnicos, pero compara la variante concreta y su licencia.
Prueba: instrucciones con varios requisitos, JSON válido, código con tests y documentos en castellano.
Dispone de un ecosistema amplio y compatibilidad en numerosos motores. La familia y la variante pueden tener condiciones distintas; no extrapoles una prueba entre tamaños o modalidades.
Prueba: seguimiento de instrucciones, consistencia multivuelta y comportamiento con herramientas.
Incluye opciones adecuadas para equipos contenidos y variantes capaces de trabajar con imagen. La relación entre tamaño y calidad puede ser atractiva para asistentes internos.
Prueba: resumen fiel, clasificación, extracción y lectura de capturas representativas.
Conviene evaluarla en problemas con respuesta verificable. Las variantes destiladas no equivalen al modelo de mayor tamaño y pueden comportarse de forma diferente.
Prueba: lógica, cálculo revisado por código y decisiones con criterios explícitos.
Es relevante para cargas que necesitan razonamiento y uso de herramientas en infraestructura propia. Comprueba requisitos del motor, cuantización y contexto operativo.
Prueba: esquemas, llamadas a función, rechazo de acciones y recuperación ante errores.
Puede aportar buenas alternativas para baja latencia y tareas concretas. Como en el resto, «la familia» no sustituye una medición de la etiqueta exacta.
Prueba: castellano, velocidad, formato y estabilidad con el contexto esperado.
Una lista no es una recomendación permanente. Las bibliotecas cambian. Esta guía conserva el método: selecciona varias familias, fija casos propios y registra la variante aprobada.
La aproximación inicial de los pesos es parámetros multiplicados por bits y divididos entre ocho. No es el consumo final: el fichero añade metadatos y el motor necesita buffers, activaciones y caché. Además, una arquitectura de mezcla de expertos puede tener muchos parámetros totales y activar solo una parte por token, pero los pesos que deben estar disponibles siguen condicionando la memoria.
memoria aproximada de pesos = parámetros × bits / 8
memoria de servicio = pesos + caché KV + buffers + margen del sistema
| Factor | Qué aumenta | Consecuencia práctica |
|---|---|---|
| Más parámetros | Pesos y cálculo por token | Mayor capacidad potencial, menor velocidad y más memoria |
| Más bits | Memoria de pesos | Puede preservar calidad, pero reduce el tamaño que cabe |
| Más contexto | Caché KV y prefill | Primera respuesta más lenta y menor concurrencia |
| Más usuarios | Cachés y colas simultáneas | Un modelo que cabe para uno puede saturar el servicio |
| Visión | Tokens visuales y componentes | Mayor latencia y memoria según número y resolución de imágenes |
| Herramientas | Historial, esquemas y resultados | El contexto crece en cada ciclo del agente |
Empieza con una cuantización intermedia que deje margen. Ejecuta los mismos casos en una variante de más precisión y otra de menos. Mide exactitud, formato, uso de herramientas y velocidad. En tareas de extracción, código o razonamiento, una diferencia pequeña en memoria puede tener más valor que una respuesta ligeramente más rápida.
Una ventana grande solo aporta valor si el modelo encuentra y utiliza la información adecuada. Documentos largos sin recuperación pueden diluir instrucciones, elevar el prefill y reducir la concurrencia. Para conocimiento empresarial, un RAG bien evaluado suele ser más controlable que introducir toda una biblioteca en cada consulta.
Construye un conjunto de casos a partir del trabajo real. El evaluador debe conocer la respuesta esperada o los criterios de aceptación. Incluye casos negativos en los que el modelo deba abstenerse, solicitudes con instrucciones contradictorias y entradas que intenten alterar el sistema.
| Prueba | Métrica principal | Fallo crítico |
|---|---|---|
| Resumen | Cobertura y fidelidad | Añadir una decisión que no aparece en la fuente |
| Extracción | Exactitud por campo | Inventar un valor obligatorio |
| RAG | Recuperación, cita y abstención | Responder sin evidencia autorizada |
| Código | Tests superados y seguridad | Proponer un cambio que rompe datos o permisos |
| Herramientas | Llamada y argumentos correctos | Ejecutar una acción no solicitada |
| Visión | Campos y relaciones visuales | Confundir una cifra o elemento decisivo |
Antes de aprobar una variante, conserva su procedencia, licencia, hash o identificador, términos aplicables, finalidad y limitaciones. «Disponible para descargar» no significa que todos los usos, redistribuciones o modificaciones estén autorizados. Revisa también el código que carga los pesos y evita formatos ejecutables de origen desconocido.
Un modelo no es una frontera de autorización. Aunque siga instrucciones con fiabilidad, no debe decidir por sí solo qué documentos puede leer ni qué acciones puede ejecutar.
Es la opción prioritaria cuando pesos, caché y lote caben en VRAM. El ancho de banda suele aportar la mejor generación interactiva.
Los 128 GB unificados permiten trabajar con modelos y contextos que ya no entran en una GPU convencional. Debe medirse la velocidad de la carga real.
RTX PRO aporta gran VRAM y velocidad; DGX Station amplía de forma sustancial la memoria coherente para modelos y usuarios más exigentes.
Entrega al dimensionador: familia, etiqueta exacta, cuantización, contexto, tokens de entrada y salida, usuarios simultáneos, tiempo objetivo, visión, herramientas, RAG y número de modelos residentes. Sin esos datos, cualquier recomendación es una aproximación.
El recomendador organiza la primera decisión; una prueba controlada confirma memoria, velocidad y concurrencia.
Instala dos o tres familias, ejecuta la misma batería y conserva el modelo menor que cumpla los requisitos. Escala memoria cuando la calidad o el contexto lo justifiquen.
Instalar OllamaLas especificaciones, funciones y límites descritos se contrastan con documentación primaria de Ollama y modelos. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Documentación oficial de Ollama · Biblioteca oficial de modelos · Contexto y comprobación de offload
Qwen3 en Ollama · Gemma 3 en Ollama · Llama 3.3 en Ollama · DeepSeek-R1 en Ollama · gpt-oss en Ollama · Qwen Coder en Ollama · nomic-embed-text
No existe uno universal. La elección depende de tarea, idioma, licencia, memoria, contexto, velocidad y herramientas. Compara familias con un conjunto de pruebas propio.
Como estimación inicial, los pesos ocupan parámetros multiplicados por bits y divididos entre ocho, más metadatos, caché y memoria del motor. La cifra real debe comprobarse en la variante concreta.
No. Datos, arquitectura, ajuste, razonamiento, herramientas y tarea pueden hacer que un modelo menor sea preferible. Además, un modelo demasiado grande puede reducir la velocidad y la concurrencia.
Qwen, Llama, Gemma, DeepSeek-R1, gpt-oss y Mistral cubren necesidades distintas. Consulta ollama.com/library para ver etiquetas, tamaños y requisitos vigentes.
No debe asumirse. Revisa la licencia de cada modelo y de sus pesos, las condiciones de uso, la procedencia y las obligaciones aplicables a tu caso.
Ejecuta el modelo y consulta ollama ps. La salida muestra el procesador utilizado y ayuda a detectar descarga parcial a CPU, que puede reducir el rendimiento.