Una unidad para validar modelo, calidad, velocidad y forma de uso.
Arquitectura de despliegue
Clústeres de DGX Spark: 2, 3 y 4 nodos sin confundir memoria y servicio
Dos DGX Spark mantienen la referencia oficial de hasta 405B para software compatible. La herramienta NVIDIA Sync también admite tres nodos en anillo y topologías de dos a cuatro nodos mediante un switch QSFP. Eso permite cargas distribuidas, pero no convierte la suma de memorias en una RAM única y transparente: el modelo y el programa que ejecuta el modelo deben soportar el reparto.
2 nodos directos3 nodos en anilloHasta 4 con switch QSFP
Compra en nuestras tiendas oficiales
AI Supercomputers te ayuda a elegir; el pedido se completa en una tienda del grupo ietres
Esta web publica las guías, comparativas y recomendadores. La ficha comercial, la disponibilidad, la reserva y la compra se gestionan en una de nuestras dos tiendas oficiales.
 tienda.ietres.comTienda multimarca del grupo. Aquí se comercializa NVIDIA DGX Spark.
 ietresinformatica.comCanal profesional del grupo para ASUS, Lenovo, RTX PRO y accesorios de IA.
Disponibilidad y reservas. La disponibilidad cambia por referencia. Si una ficha aparece sin stock, consulta la tienda: algunas unidades pueden reservarse o pedirse sobre una próxima entrada. El plazo y las condiciones se confirman antes de comprar.
Ruta para pymes
Para la mayoría de pymes, un clúster no es el punto de partida
Empieza con una unidad y mide. Una pareja tiene sentido cuando el modelo o el contexto no caben con margen en un solo equipo. Tres o cuatro nodos son una ampliación avanzada, no una compra preventiva.
El bundle x2 cuando la necesidad de repartir una carga compatible esté demostrada.
Anillos de tres nodos, switches, paralelismo distribuido y operación de varias máquinas.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Decisión rápida para una pyme
Antes de añadir nodos, responde tres preguntas
El número de equipos es el último dato, no el primero.
Mide pesos, contexto y caché. Si una unidad no basta, prueba primero dos nodos con el motor previsto.
Usa réplicas y una cola. No necesitas dividir el modelo si cada copia cabe en una unidad.
Valida topología, cables, switch cuando corresponda y compatibilidad del programa que ejecuta el modelo antes de comprar.
Ver las topologías →Alcance del proyecto. Antes de comprar varias unidades, describe el modelo, el programa que ejecuta el modelo, la topología prevista y el número de usuarios. Así se puede valorar el hardware, el cableado y las opciones disponibles sin dar por supuesto que cualquier carga se reparte automáticamente.
Hardware relacionado
Equipos y cables para empezar por una o dos unidades
La pareja es la compra más sencilla. Tres o cuatro nodos requieren además una topología de red y software distribuido validados.
NVIDIA · 4 TB
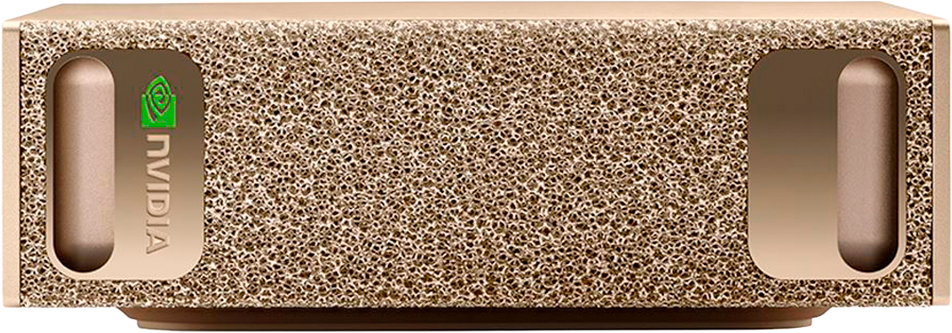
NVIDIA DGX Spark
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
NVIDIA · Bundle x2
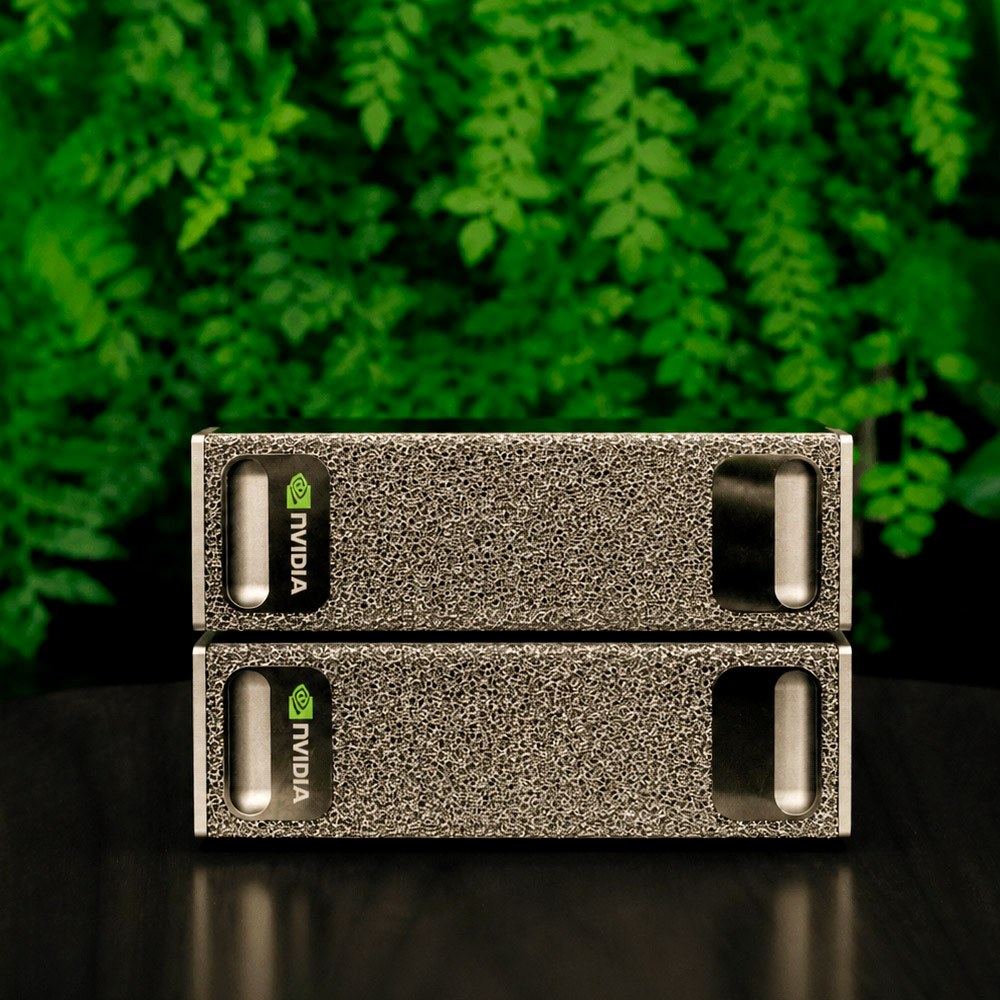
DGX Spark Bundle x2
Dos unidades Founders Edition en una única ficha comercial para preparar una pareja compatible. Comprueba en la ficha el contenido exacto y añade el cable QSFP adecuado cuando corresponda.
Compra entienda ietres
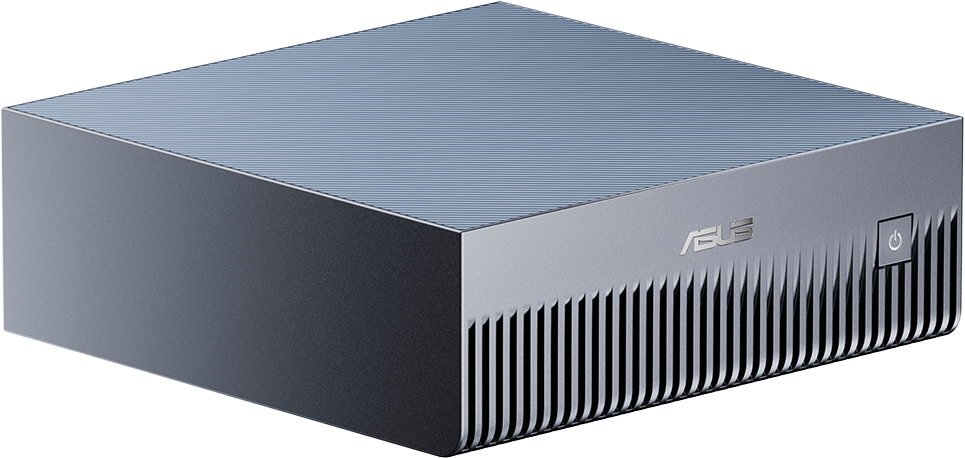
GB10 · 1, 2 o 4 TB
ASUS Ascent GX10
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
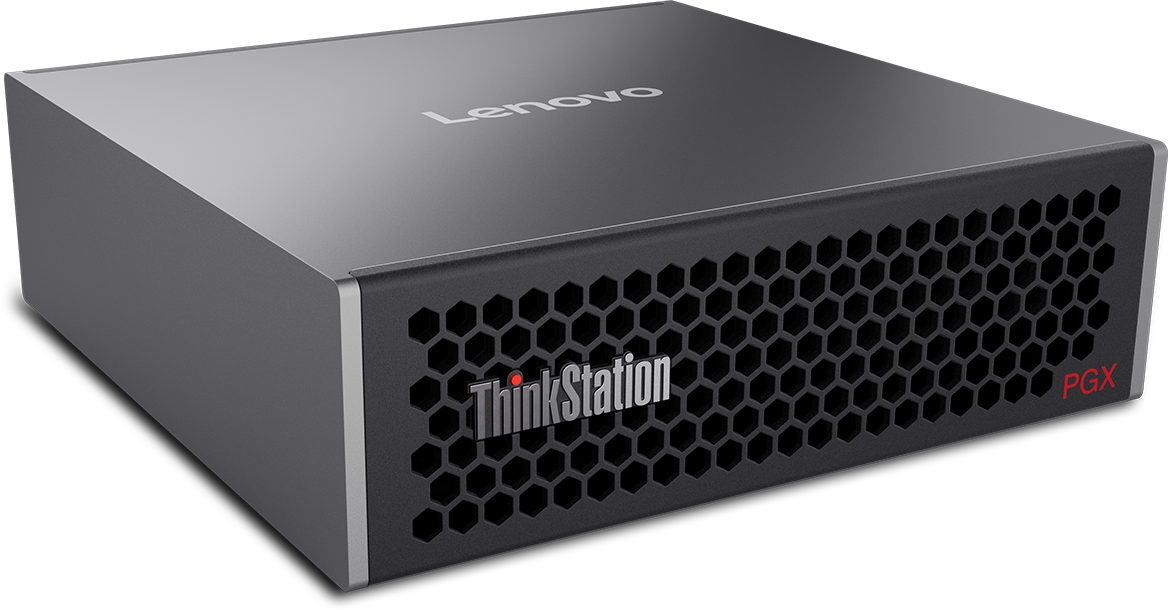
GB10 · 1, 2 o 4 TB
Lenovo ThinkStation PGX
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
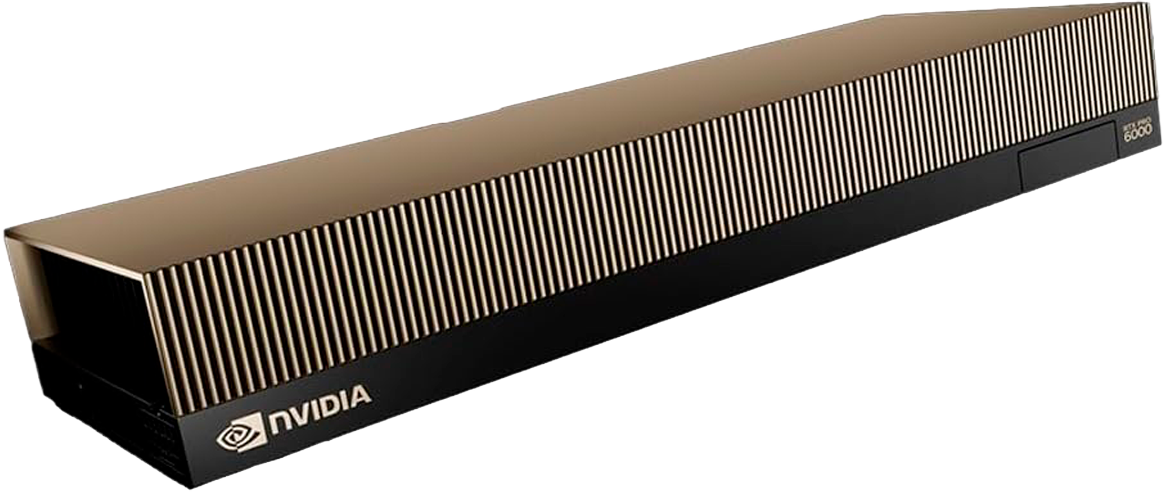
GPU de servidor · 96 GB
RTX PRO 6000 Blackwell
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
Compra de la pareja
Bundle x2 de NVIDIA DGX Spark
La ficha agrupa dos unidades Founders Edition para quienes ya han validado la necesidad de una pareja. El bundle simplifica el pedido de los dos equipos, pero la conexión de un único modelo compatible sigue necesitando la receta de software soportada y un cable QSFP adecuado.
- Dos unidades DGX Spark Founders Edition.
- 128 GB de memoria coherente por unidad.
- Comprueba en la ficha qué accesorios están incluidos.
- El cable QSFP se consulta por separado cuando no forme parte del paquete.
La referencia oficial de hasta 405B sigue siendo una pareja
En palabras sencillas
Dos unidades pueden repartirse un modelo compatible mediante un motor distribuido. NVIDIA utiliza esta pareja como referencia para modelos de hasta 405.000 millones de parámetros. No es una suma automática de RAM: el software decide qué parte ejecuta cada nodo.
La pareja directa utiliza ConnectX-7 y un cable QSFP compatible. Ambos equipos deben compartir versiones de sistema, contenedor, programa que ejecuta el modelo, modelo y parámetros. El formato, la cuantización, el contexto y la caché determinan la memoria realmente utilizable.
Para una pyme: compra una pareja solo después de probar el mismo modelo y motor en una unidad o de disponer de una prueba reproducible del proveedor del software.
Cuatro formas de aprovechar varios nodos
En palabras sencillas
Más equipos pueden servir para que quepa un modelo mayor, para responder a más usuarios o para separar tareas. Son objetivos distintos y no requieren la misma arquitectura.
Repartir un modelo compatible
El programa que ejecuta el modelo divide tensores, capas o expertos entre dos, tres o cuatro nodos. Debe soportar esa topología y demostrar rendimiento estable.
Responder a más usuarios
Cada nodo mantiene una copia completa del modelo y un balanceador envía cada petición a una réplica disponible.
Repartir trabajos completos
Documentos, embeddings, transcripciones o lotes se asignan al siguiente nodo libre sin dividir una tarea individual.
Un modelo por función
Un nodo puede atender chat, otro embeddings y otro visión. Es fácil de entender y suele encajar mejor en una pyme.
¿Qué cambia entre 1, 2, 3 y 4 DGX Spark?
La idea clave
NVIDIA Sync valida dos nodos conectados directamente, tres nodos formando un anillo y de dos a cuatro nodos conectados a un switch QSFP. La topología física puede quedar preparada, pero el reparto de un modelo solo funciona si el programa que ejecuta el modelo y ese modelo admiten tensor parallelism, pipeline parallelism u otro patrón distribuido.
| Nodos | Conexión de cómputo | Uso razonable | Qué debes comprobar |
|---|---|---|---|
| 1 | Sin interconexión adicional | Piloto, desarrollo y servicio de un equipo pequeño | Memoria, velocidad y concurrencia reales |
| 2 | Un cable QSFP directo | Referencia de hasta 405B con software compatible, o dos réplicas | Motor distribuido, versiones, cable y recuperación |
| 3 | Anillo directo con tres cables QSFP | Paralelismo de modelo validado, tres réplicas o tareas separadas | Soporte de 3 nodos, reparto elegido y latencia entre enlaces |
| 4 | Cada nodo a un switch QSFP gestionable | Hasta 512 GB agregados para software distribuido, cuatro réplicas o flujos especializados | Switch compatible con RoCEv2, cableado, programa que ejecuta el modelo y pruebas de carga |
| Más de 4 | Diseño manual y normalmente con switch | Servicio distribuido o investigación específica | Ya no es una ampliación sencilla para una pyme; exige ingeniería y operación propias |
- No multipliques parámetros por número de nodos. Cuatro unidades no garantizan automáticamente el doble que una pareja.
- La memoria es agregada, no transparente. Cada nodo conserva su memoria y el framework mueve datos entre ellos.
- Para más usuarios, empieza por réplicas. Es más sencillo de operar que un único modelo repartido.
- Para tres o cuatro nodos, valida antes de comprar. Reproduce el modelo, la cuantización, el contexto y la versión exacta del programa que ejecuta el modelo.
NVIDIA documenta estas topologías mediante el Cluster Assistant de NVIDIA Sync. La cifra de 405B continúa asociada de forma explícita a la pareja; para tres o cuatro nodos no debe publicarse un límite de parámetros sin una prueba del modelo y el motor concretos.
Fuentes técnicas: NVIDIA Sync Cluster Assistant y guía de clustering multi-nodo de NVIDIA.
El cableado depende del número de nodos
Dos unidades pueden conectarse directamente con un cable QSFP. Tres unidades utilizan los dos puertos ConnectX-7 de cada equipo para formar un anillo. Para cuatro nodos, NVIDIA Sync contempla un switch QSFP gestionable; cada Spark mantiene además su red de administración y acceso de usuarios.
Enlace directo
Un cable entre el mismo puerto de ambos equipos. Es la topología más sencilla.
Anillo
Cada equipo se conecta a los otros dos. Se necesitan tres cables y una configuración coherente.
Switch QSFP
Cada unidad se conecta al switch. Comprueba RoCEv2, velocidad de puertos, MTU y gestión.
La red Ethernet de 10 GbE o Wi‑Fi puede seguir usándose para administración, descargas y acceso de usuarios. El tráfico distribuido de alto rendimiento debe circular por la red ConnectX configurada para ese fin.
Calcula servicio, no solo memoria
| Métrica | Qué mide | Por qué importa |
|---|---|---|
| Tiempo de cola | Espera antes de empezar | Revela falta de réplicas o una prioridad mal definida |
| Prefill | Lectura del contexto | Domina en documentos, código y RAG con entradas largas |
| Generación | Tokens de salida por segundo | Determina la sensación de respuesta durante la producción |
| Concurrencia | Sesiones activas | Puede reducir el rendimiento por usuario aunque aumente el total |
| Memoria libre | Margen tras cargar pesos y caché | Evita fallos al crecer el contexto o el lote |
| Errores y reinicios | Estabilidad por versión | Permite detener despliegues defectuosos |
Empieza con una prueba de carga representativa: distribución real de prompts, contexto, salidas y usuarios. El promedio no basta; utiliza percentiles de latencia y contempla picos.
Seguridad, actualización y recuperación
- Identidad y autorización: ningún endpoint de modelos debe quedar abierto por conveniencia. Aplica autenticación, roles, límites y segmentación de red.
- Versionado: fija imágenes, motores, modelos y configuraciones. Actualiza por etapas y conserva una ruta de reversión.
- Datos: separa modelos, índices, documentos y registros; define copia, cifrado y retención para cada conjunto.
- Secretos: no introduzcas credenciales en prompts ni variables visibles. Utiliza un gestor y permisos mínimos.
- Observabilidad: correlaciona solicitud, modelo, versión, nodo, tiempos y errores sin registrar más datos personales de los necesarios.
- Continuidad: comprueba qué ocurre si cae un nodo, la red, el almacenamiento o el coordinador.
Para una interfaz de equipo, consulta Open WebUI. Para automatizaciones con revisión humana, consulta n8n, Ollama y Outlook. Para tratamiento de datos personales, revisa IA local y RGPD.
Información técnica opcional: reparto de modelos, colas y operación de varios nodos
No necesitas esta parte para completar el tutorial básico. Ábrela únicamente si vas a administrar el sistema, compartirlo con más personas o resolver una incidencia.
Qué significa conectar dos DGX Spark para un modelo de hasta 405B
Dos unidades pueden conectarse mediante la interfaz ConnectX con un cable QSFP compatible para ejecutar cargas distribuidas admitidas por el software. Esto no crea un único espacio de memoria compartida transparente para cualquier aplicación. El framework divide o coordina el trabajo y ambas unidades deben utilizar una configuración compatible.
DGX Spark A ⇄ enlace ConnectX / QSFP ⇄ DGX Spark B
       ↘ red de gestión y usuarios ↙
           almacenamiento / servicio
- Iguala versiones. Sistema, controladores, contenedores, programa que ejecuta el modelo y modelo deben estar alineados.
- Instala el enlace dedicado. Utiliza el puerto y cable compatibles; no lo sustituyas por una red convencional y esperes el mismo comportamiento.
- Configura direccionamiento y prueba conectividad. Verifica enlace, MTU cuando corresponda, latencia y ancho de banda antes del modelo.
- Distribuye el artefacto. Ambos nodos necesitan acceso coherente a pesos y configuración.
- Utiliza un motor que soporte el patrón. La división del modelo depende del framework y de la receta concreta.
- Mide memoria y comunicación. El enlace puede convertirse en parte de la latencia.
- Prueba recuperación. Define qué ocurre si un nodo se reinicia o pierde el enlace.
El límite citado por NVIDIA es una capacidad de plataforma, no una garantía universal. Formato, cuantización, caché, contexto y motor determinan si una variante concreta funciona y con qué velocidad.
Elige entre repartir el modelo o repartir las peticiones
| Patrón | Qué reparte | Cuándo utilizarlo |
|---|---|---|
| Paralelismo de modelo en 2–4 nodos | Tensores, capas o expertos de un único modelo | Cuando una unidad no basta y el programa que ejecuta el modelo soporta exactamente esa topología |
| Réplicas | Solicitudes entre copias completas | Más usuarios, disponibilidad y menor cola |
| Cola de trabajos | Tareas completas por nodo | Embeddings, transcripción, imagen, vídeo o lotes |
| Modelo por función | Chat, embeddings, reranker o visión | Aislar recursos y simplificar la operación |
| Laboratorio | Entornos por proyecto o equipo | Evitar conflictos de dependencias y modelos |
Para una pyme, réplicas y tareas separadas suelen ser más fáciles de mantener. Utiliza paralelismo de modelo únicamente cuando la capacidad de una unidad sea el límite y exista una receta probada para el motor elegido.
Separar tráfico de modelo, gestión, datos y usuarios
La topología ConnectX atiende la comunicación distribuida. Dibuja además la red de gestión y servicio: consultas de usuarios, acceso a documentos, métricas, copias y administración. No mezcles todos los flujos sin saber qué ancho de banda y permisos necesita cada uno.
Pesos e índices
Distribuye artefactos desde un repositorio controlado y verifica hashes. Evita que cada nodo descargue variantes diferentes.
API y balanceo
El balanceador conoce salud, cola y modelo cargado. Una respuesta de puerto abierto no prueba que la réplica esté lista.
Administración separada
Limita SSH y consolas a una red de administración con identidad y registros.
Métricas y logs
Recoge telemetría sin mezclarla con prompts o datos sensibles salvo necesidad documentada.
- Diagrama con interfaces, subredes y reglas
- DNS o inventario estable de nodos
- Sin puertos de inferencia expuestos a Internet
- Pruebas de latencia y rendimiento sostenido
- Rutas de copia y actualización separadas
- Capacidad de aislar un nodo sin detener toda la flota
Encolar, enrutar y limitar trabajos según el modelo que está residente
Un balanceador genérico puede distribuir HTTP, pero no conoce memoria, modelo, contexto ni tiempo de carga. Añade una capa que anuncie capacidad y salud. Evita descargar y cargar modelos en cada petición; agrupa trabajos o dedica nodos a modelos estables.
Cliente → autenticación → router de modelos → cola
                                      ↘ réplica A
                                      ↘ réplica B
                                      ↘ lote / trabajo largo
- Identifica el modelo solicitado. Solo rutas aprobadas y variantes existentes.
- Calcula prioridad y límites. Usuario, tamaño de contexto, tipo de carga y cuota.
- Selecciona una réplica saludable. Considera cola, memoria, versión y modelo residente.
- Asigna un identificador. Permite cancelación, seguimiento e evitar acciones duplicadas.
- Establece tiempo máximo. Un trabajo bloqueado no ocupa el nodo indefinidamente.
- Devuelve errores claros. Cola llena, modelo no disponible, contexto excesivo o servicio temporalmente no preparado.
Para lotes, utiliza una cola persistente y trabajadores. Para chat, conserva streaming y límites de sesión. Mezclar vídeo largo con conversación interactiva en la misma cola produce una experiencia impredecible.
Calcular nodos por demanda y nivel de servicio
Empieza por mediciones de una unidad o pareja: tiempo de carga, prefill, generación y memoria. Después utiliza el volumen y la concurrencia. Una media diaria baja puede ocultar un pico que satura el servicio.
trabajos por hora por réplica ≈ 3600 / tiempo medio del trabajo
capacidad útil = capacidad medida × factor de margen
réplicas necesarias = demanda pico / capacidad útil
| Dato | Por qué importa |
|---|---|
| Distribución de contexto | El prefill y la memoria no crecen igual en todas las consultas |
| Longitud de salida | Determina ocupación del nodo durante generación |
| Usuarios simultáneos | Crea cachés y cola, aunque el total diario sea moderado |
| Modelo residente | Cambiar de modelo añade carga y puede fragmentar capacidad |
| Percentil alto de latencia | Representa la experiencia en picos |
| Disponibilidad requerida | Puede exigir capacidad de reserva y actualizaciones por rotación |
Reserva capacidad para mantenimiento y fallos. Si la carga necesita todas las unidades para cumplir en condiciones normales, no existe tolerancia a una actualización o avería.
Versionar, monitorizar y recuperar una flota homogénea
- Imagen base, controladores y contenedores registrados
- Repositorio único de modelos con hashes
- Inventario de nodo, función, red y versión
- Actualización por grupos, no de toda la flota a la vez
- Pruebas de carga y calidad antes de promover
- Métricas de memoria, temperatura, cola, prefill y generación
- Alertas de diferencia de versión o artefacto
- Copias de configuración, índices y secretos cifrados
- Procedimiento para retirar un nodo comprometido
- Simulación de fallo de red, almacenamiento y modelo
La seguridad debe cubrir los nodos y la capa de acceso. Usa identidades de servicio, credenciales por función y segmentación. Un modelo no necesita permisos para administrar la infraestructura.
Datos necesarios para configurar dos unidades o una flota
| Área | Información |
|---|---|
| Modelo | Familia, variante, cuantización, formato y motor |
| Contexto | Medio, máximo y datos RAG o herramientas |
| Servicio | Usuarios, pico, latencia y disponibilidad |
| Patrón | Pareja para un modelo, réplicas, lotes o funciones |
| Datos | Ubicación, tamaño, permisos y actualización |
| Red | Topología, acceso, segmentación y enlace entre unidades |
| Operación | Monitorización, copias, mantenimiento y soporte |
Hardware verificable
Ver cable QSFPLa pareja oficial necesita el enlace correcto
La ficha del cable QSFP compatible y la del DGX Spark permiten cerrar referencias concretas. Una flota adicional se diseña según servicio, no como una cadena de memoria improvisada.
Qué trabajo puede repartirse entre una flota sin fingir un único modelo gigante
| Carga | Patrón de escala | Unidad de reparto | Métrica principal |
|---|---|---|---|
| Inferencia privada | Réplicas del mismo modelo | Petición o sesión | Latencia, colas y disponibilidad |
| Procesado documental | Trabajadores especializados | Documento o lote | Documentos por hora y reintentos |
| Transcripción | Cola de ficheros de audio | Archivo o segmento | Horas de audio por hora |
| Laboratorio o aula | Asignación por usuario o proyecto | Sesión, contenedor o modelo | Espera y aislamiento |
| Agentes | Servicios por función | Trayectoria o herramienta | Tiempo total, errores y pasos |
| Banco de pruebas | Ejecuciones paralelas reproducibles | Modelo, prompt o checkpoint | Comparabilidad y utilización |
Estas cargas escalan horizontalmente porque cada trabajo puede asignarse a un nodo o servicio. Para un único modelo, dos, tres o cuatro nodos pueden participar si el programa que ejecuta el modelo soporta el reparto y la topología se ha validado; no debe asumirse una memoria continua ni una mejora lineal.
Las capas que convierten varios equipos en un servicio operable
| Capa | Función | Pregunta de aceptación |
|---|---|---|
| Programa que ejecuta el modelo de modelo | Carga pesos, contexto y backend distribuido cuando procede | ¿La variante y la arquitectura están soportadas? |
| Cola y planificador | Asigna trabajos, prioridades, límites y reintentos | ¿Evita duplicados y conserva estado? |
| Enrutador | Selecciona modelo, réplica o función | ¿Conoce capacidad y salud de cada destino? |
| Almacenamiento | Distribuye pesos, índices, entradas y resultados | ¿Versiona y evita copiar datos innecesarios? |
| Identidad y secretos | Autoriza usuarios y servicios | ¿Las credenciales quedan fuera de prompts y contenedores? |
| Observabilidad | Mide GPU, memoria, cola, errores y calidad | ¿Permite relacionar una respuesta con modelo y nodo? |
| Configuración | Reproduce imágenes, variables y despliegues | ¿Puede reinstalarse un nodo sin configuración manual? |
| Recuperación | Retira nodos, revierte y restaura datos | ¿Existe una prueba de fallo y vuelta al servicio? |
Empieza con una pareja o una pequeña flota y fuerza fallos: modelo que no carga, nodo fuera de red, trabajo duplicado, cola saturada y actualización fallida. Un clúster es útil cuando mantiene el servicio bajo estas condiciones, no cuando todos los nodos aparecen en un panel.
Diseña la flota a partir del nivel de servicio
Usuarios, distribución de contexto, modelos, latencia objetivo, ventanas de mantenimiento y recuperación definen el número de nodos y la topología.
Consultar compra y disponibilidadFuentes técnicas y criterio editorial
Las especificaciones, funciones y límites descritos se contrastan con documentación primaria de NVIDIA DGX Spark y clústeres. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Ficha oficial de DGX Spark · Hardware de DGX Spark · Topologías validadas de dos a cuatro nodos
Respuestas directas
¿Se pueden conectar tres DGX Spark sin switch?
Sí. NVIDIA Sync admite una topología en anillo de tres nodos: cada Spark utiliza sus dos puertos ConnectX-7 para conectarse a los otros dos. Se necesitan tres cables QSFP y una configuración de red coherente.
¿Se pueden conectar cuatro DGX Spark?
Sí. NVIDIA Sync valida topologías de dos a cuatro nodos mediante un switch QSFP compatible. La suma de memoria alcanza 512 GB de hardware, pero cada nodo conserva su memoria y el software debe soportar el reparto.
¿Cuántos parámetros admite un clúster de tres o cuatro nodos?
No existe una cifra universal publicada que pueda calcularse multiplicando el límite de una unidad. NVIDIA cita hasta 405B para dos Spark. En tres o cuatro nodos dependen del modelo, la cuantización, el contexto, la caché y el programa que ejecuta el modelo distribuido.
¿Para una pyme es mejor repartir un modelo o usar réplicas?
Si el modelo cabe en una unidad, las réplicas suelen ser más sencillas: atienden más peticiones y aíslan fallos. Reparte un único modelo solo cuando la falta de memoria sea el límite real.
¿Puedo consultar una configuración de varios nodos?
Puedes consultar el alcance indicando cuántos nodos, qué modelo o carga quieres ejecutar, el software previsto y la topología de red. La viabilidad debe confirmarse antes de comprar cables, switches o unidades adicionales.
¿Todavía no necesitas toda esta parte avanzada?
No pasa nada: empieza por lo esencial y vuelve aquí cuando el uso crezca. Para muchas pymes, el primer paso se reduce a un equipo, un uso concreto y una receta — la guía práctica para pymes — y esta página seguirá aquí, esperándote, el día que toque crecer.