ASUS o Lenovo de 1 TB para una biblioteca controlada y un primer equipo dedicado.
Superchip Grace Blackwell · guía de compra
NVIDIA GB10: qué es y qué superordenador de IA comprar
GB10 es la base de NVIDIA DGX Spark, ASUS Ascent GX10 y Lenovo ThinkStation PGX. Esta guía explica la memoria unificada de 128 GB, cuándo aporta una ventaja real, qué limita el rendimiento y cómo elegir una referencia sin confundir SSD, memoria y velocidad.
Capacidad frente a velocidadCompatibilidad Arm64Compra por referencia exacta
Ruta para pymes
Para una pyme, GB10 se elige por memoria; el SSD se elige por espacio
ASUS, Lenovo y DGX Spark comparten una clase de memoria de 128 GB. Una variante de 1 TB puede ser una entrada suficiente si guardarás pocos modelos. Más SSD no permite ejecutar un modelo mayor.
2 o 4 TB si vas a conservar más modelos, datasets, contenedores y resultados.
Parejas y clústeres de varios nodos.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Compra en nuestras tiendas oficiales
AI Supercomputers te ayuda a elegir; el pedido se completa en una tienda del grupo ietres
Esta web publica las guías, comparativas y recomendadores. La ficha comercial, la disponibilidad, la reserva y la compra se gestionan en una de nuestras dos tiendas oficiales.
 tienda.ietres.comTienda multimarca del grupo. Aquí se comercializa NVIDIA DGX Spark.
 ietresinformatica.comCanal profesional del grupo para ASUS, Lenovo, RTX PRO y accesorios de IA.
Disponibilidad y reservas. La disponibilidad cambia por referencia. Si una ficha aparece sin stock, consulta la tienda: algunas unidades pueden reservarse o pedirse sobre una próxima entrada. El plazo y las condiciones se confirman antes de comprar.
En lenguaje claro
GB10 resuelve un límite de memoria, no sustituye a cualquier GPU
En palabras sencillas
El GB10 es "el motor" que comparten DGX Spark, ASUS GX10 y Lenovo PGX: dos cerebros (CPU y GPU) fabricados juntos y trabajando sobre la misma memoria de 128 GB — como una cocina donde cocinero y ayudante comparten la encimera en lugar de pasarse platos por una ventanilla. Por eso equipos de marcas distintas rinden igual: llevan el mismo corazón.
Qué contiene
Una CPU Grace basada en Arm, una GPU Blackwell y memoria unificada. CPU y GPU trabajan sobre el mismo gran espacio de memoria, evitando el límite rígido de una tarjeta gráfica con poca VRAM.
Qué ventaja ofrece
Puede cargar modelos, contextos y servicios que no caben con margen en muchas GPU convencionales. Es especialmente útil cuando la capacidad impide siquiera iniciar la carga.
Qué no garantiza
No garantiza más tokens por segundo. Cuando la carga cabe en la VRAM de una GPU profesional, esa GPU puede ser claramente más rápida. La elección correcta depende de una medición, no del nombre comercial.
No compares el petaFLOP FP4 de IA con FLOPS científicos FP64. Son precisiones y cargas distintas. Para comprar, mide el modelo real, su cuantización, el contexto y la concurrencia.
Tres formas de comprar GB10
La plataforma central coincide; la referencia comercial no
| Equipo | Memoria | SSD incluido en esta selección | Cuándo mirarlo primero | Qué confirmar |
|---|---|---|---|---|
| NVIDIA DGX Spark | 128 GB unificados | 4 TB | Quieres la plataforma de referencia NVIDIA y una ficha directa en tienda.ietres.com | Programa que ejecuta el modelo, compatibilidad Arm64, soporte y rendimiento de tu modelo |
| ASUS Ascent GX10 | 128 GB unificados | 1, 2 o 4 TB | Quieres elegir capacidad local dentro de la familia ASUS | P/N, almacenamiento, imagen del sistema y condiciones de la ficha |
| Lenovo ThinkStation PGX | 128 GB unificados | 1, 2 o 4 TB | Quieres una referencia ThinkStation del canal profesional Lenovo | P/N, EAN, servicio y cobertura; hay referencias que comparten SSD |
Compra guiada
Compara la plataforma antes de abrir una ficha
Desplázate por las alternativas. Cada tarjeta separa la guía técnica de la ficha comercial para que puedas validar el encaje antes de comprar.
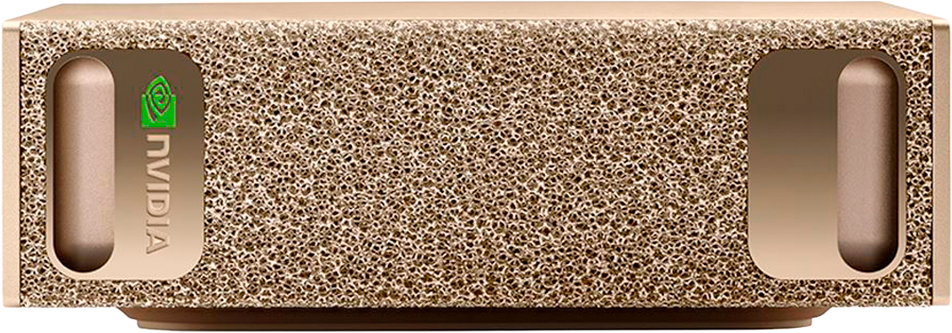
NVIDIA · GB10 · 4 TB
NVIDIA DGX Spark
Plataforma de referencia NVIDIA para cargas que necesitan 128 GB de memoria unificada.
Compra entienda ietres
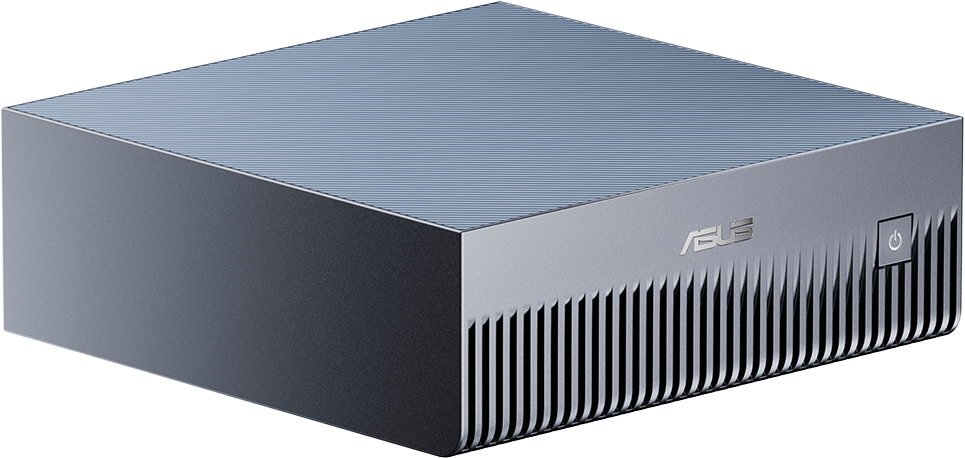
ASUS · GB10 · 1, 2 o 4 TB
ASUS Ascent GX10
Tres escalones de almacenamiento sobre la misma clase de memoria GB10.
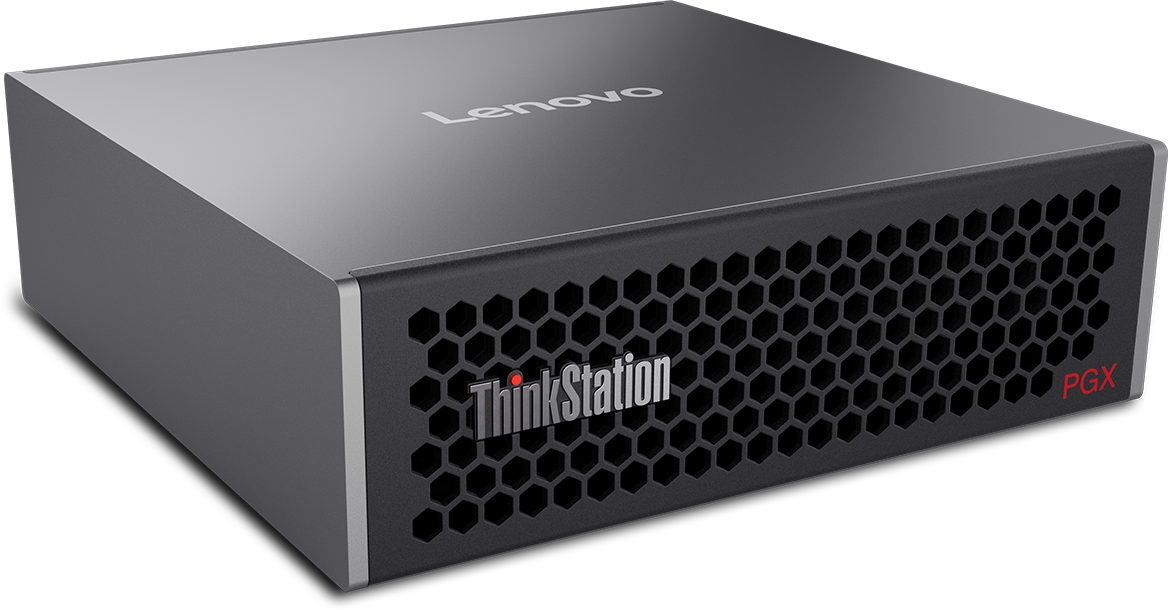
Lenovo · GB10 · 1, 2 o 4 TB
ThinkStation PGX
Varias referencias comerciales Lenovo; conserva P/N y EAN al comparar.
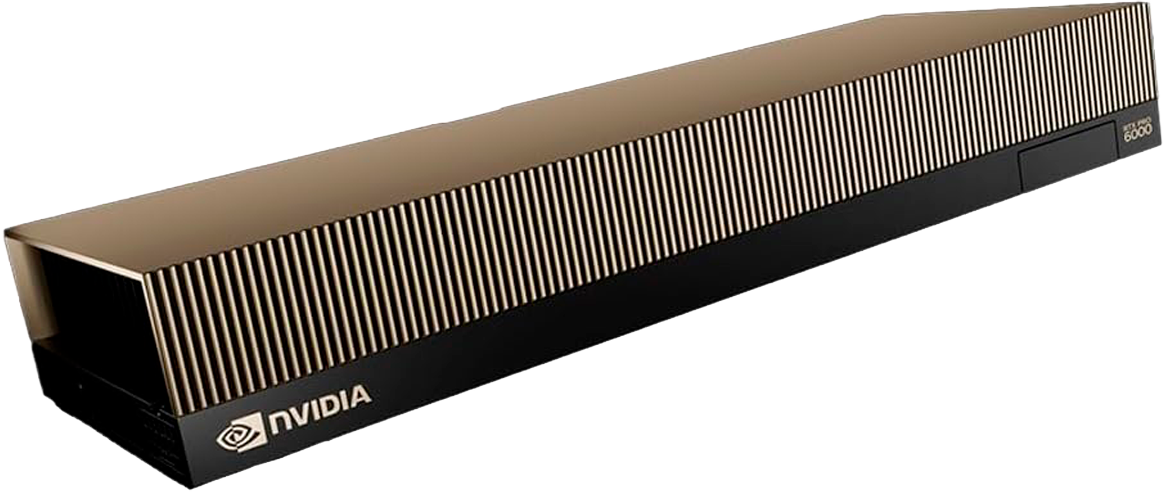
GPU de servidor · 96 GB
RTX PRO 6000 Blackwell
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM.
Compra enietres informática
Arquitectura
La memoria unificada es una mesa de trabajo grande
En una estación con GPU convencional, los pesos y la caché deben caber en la VRAM. Si una parte cae en memoria del sistema, el rendimiento puede descender de forma pronunciada. En GB10, CPU y GPU comparten un espacio coherente de 128 GB. La mesa es mayor, pero la velocidad con la que se mueve cada elemento sigue dependiendo del hardware y del software.
- Calcula el tamaño de los pesos después de cuantizar.
- Añade la caché KV del contexto máximo y las sesiones simultáneas.
- Reserva margen para el programa que ejecuta el modelo, buffers, sistema y fragmentación.
- Comprueba que el backend y las extensiones funcionan en Arm64.
- Ejecuta la misma prueba en la alternativa GPU antes de decidir.

Dimensionamiento paso a paso
Cómo decidir sin comprar por intuición
- Define una tarea. Elige un prompt, documento o flujo de trabajo que represente el trabajo real.
- Fija modelo y cuantización. No dimensionas una familia abstracta; dimensionas un artefacto concreto.
- Mide memoria. Registra memoria al cargar, durante el prefill y con el contexto máximo.
- Mide servicio. Anota primer token, latencia total, tokens por segundo, errores y usuarios simultáneos.
- Comprueba software. Valida contenedores, librerías, nodos y herramientas en la arquitectura Arm64.
- Elige SSD. Cuenta modelos, datasets, imágenes de contenedor, cachés, resultados y margen de actualización.
- Compara referencias. Abre P/N y EAN exactos; el mismo SSD no implica el mismo paquete comercial.
Resultado correcto
Debes terminar con una ficha que diga «este modelo necesita esta memoria, alcanza esta latencia y requiere este software», no únicamente «quiero un equipo potente».
Dos unidades
Una pareja amplía capacidad; una flota resuelve otra clase de problema
ConnectX-7 permite enlazar varios equipos compatibles. Dos nodos mantienen la referencia de hasta 405B; NVIDIA Sync valida tres nodos en anillo y hasta cuatro mediante switch. El programa que ejecuta el modelo debe soportar el reparto y la memoria no se convierte en un espacio único automático.
- Un solo modelo grande: valida la receta oficial de dos unidades y el cable correcto.
- Más usuarios: usa réplicas, balanceo, colas y límites de concurrencia.
- Procesos por lotes: reparte trabajos independientes y conserva trazabilidad.
- Alta disponibilidad: separa capacidad de servicio y recuperación; una pareja de cómputo no sustituye las copias.

Siguiente paso de compra
Elige arquitectura, SSD y referencia en ese orden
Primero confirma que necesitas 128 GB unificados. Después escoge el espacio local. Por último abre el SKU exacto y comprueba soporte, servicio y condiciones comerciales.
Qué puedes ejecutar
Modelos, software y límites que conviene validar
| Carga o software | Encaje | Comprobación |
|---|---|---|
| Ollama y LM Studio | Disponibles en Linux Arm64 en versiones actuales. | Confirma programa que ejecuta el modelo, formato del modelo y aceleración en la imagen del fabricante. |
| Llama 3.3 70B / DeepSeek-R1 70B | Las etiquetas citadas por Ollama ocupan 43 GB. Ese tamaño está por debajo de 128 GB, pero no demuestra que pesos, contexto, caché y buffers quepan juntos. | Añade contexto, buffers y prueba la velocidad del backend. |
| gpt-oss 120B | La etiqueta citada por Ollama ocupa 65 GB. El archivo está por debajo de 128 GB, pero el encaje completo debe comprobarse con el backend y el contexto reales. | Compara rendimiento con RTX PRO 6000 si la velocidad es prioritaria. |
| Qwen3 235B | La etiqueta citada por Ollama ocupa 142 GB, por encima de la capacidad nominal de una unidad de 128 GB antes de sumar programa que ejecuta el modelo y contexto. | Necesita reparto compatible o una variante menor. |
| ComfyUI, SDXL y Flux | Posibles con una pila Arm64 compatible. | Una GPU discreta puede ser más rápida cuando el flujo de trabajo cabe en VRAM. |
| Docker y contenedores | La plataforma admite Docker y stack NVIDIA. | Comprueba que la imagen tenga variante Arm64/GB10. |
| Windows | No es la ruta nativa de GB10. | La plataforma utiliza Linux Arm64. |
Preguntas frecuentes
Respuestas antes de elegir hardware
¿Qué es NVIDIA GB10?
Es un superchip que combina una CPU Grace basada en Arm y una GPU Blackwell con una memoria unificada accesible por ambos procesadores. En estos sistemas la capacidad anunciada es de 128 GB.
¿DGX Spark, ASUS Ascent GX10 y Lenovo ThinkStation PGX rinden exactamente igual?
Comparten la clase de plataforma GB10, pero el rendimiento práctico también depende de la refrigeración, la imagen del sistema, los controladores, el almacenamiento, el programa que ejecuta el modelo, el modelo y la configuración. Deben medirse con la misma carga.
¿Por qué una GPU puede ser más rápida aunque tenga menos memoria?
La memoria dedicada y el ancho de banda de una GPU profesional pueden reducir la latencia cuando toda la carga cabe en VRAM. GB10 adquiere valor cuando la capacidad necesaria supera ese límite o se busca una plataforma compacta con memoria unificada.
¿El SSD de 4 TB permite ejecutar modelos más grandes que el de 1 TB?
No. El SSD determina cuántos modelos, contenedores y datos puedes guardar localmente. La memoria que limita la ejecución del modelo continúa siendo la memoria unificada de 128 GB.
¿Puedo unir varios equipos GB10?
Sí. Dos nodos mantienen la referencia de hasta 405B. NVIDIA Sync valida tres nodos en anillo y hasta cuatro mediante switch; el reparto de un modelo depende del programa que ejecuta el modelo y no crea una memoria transparente.
¿Qué debo comprobar antes de comprar?
Modelo y cuantización, contexto máximo, usuarios simultáneos, memoria medida, latencia objetivo, compatibilidad Arm64, espacio local, soporte de la referencia y procedimiento de recuperación.
Fuentes técnicas y criterio editorial
Las especificaciones, funciones y límites descritos se contrastan con documentación primaria de NVIDIA GB10 y sistemas OEM. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
NVIDIA DGX Spark · ASUS Ascent GX10: especificaciones · Lenovo ThinkStation PGX · Llama 3.3 en Ollama · DeepSeek-R1 en Ollama · gpt-oss en Ollama · Qwen3 en Ollama