Antes de empezar
- Ollama instalado
- Una tarea concreta, por ejemplo resumir o redactar
- Un texto real de prueba que no contenga datos sensibles
AI Supercomputers es el portal de IA local del grupo ietres.La compra se realiza en nuestras tiendas oficiales. Si una referencia no aparece con stock, consulta la posibilidad de reserva y la siguiente entrada prevista.
Ollama simplifica la descarga y ejecución de modelos, expone una API local y se integra con herramientas como Open WebUI y n8n. También admite modelos cloud; para un entorno exclusivamente local hay que desactivar expresamente esas funciones.
Al terminar sabrás descargar un modelo, conversar con él, ver qué modelos tienes y comprobar cuánta memoria está utilizando.
No necesitas entender toda la parte técnica para comenzar. Sigue el recorrido básico y abre los apartados avanzados únicamente cuando la primera prueba funcione.
Ignora al principio la API, los embeddings y los parámetros avanzados. Ejecuta un modelo, prueba tu tarea y comprueba memoria y velocidad. Las integraciones se añaden cuando la respuesta ya merece la pena.
Descargar un modelo pequeño, hacer preguntas reales y guardar los resultados.
Cambia de hardware si el modelo que funciona no cabe o responde demasiado lento.
API compartida, modelos residentes, embeddings y optimización de contexto.
La explicación avanzada continúa debajo. Puedes consultarla cuando el uso, los datos o el número de personas lo justifiquen.
Ejecuta la guía sobre un entorno de prueba. No avances a producción hasta obtener la salida verificable y documentar la reversión.
Un equipo compatible, espacio de disco y una red en la que no vayas a publicar el puerto del programa que ejecuta el modelo.
Ejecutar, inspeccionar y consumir un modelo local mediante CLI y API con una configuración verificable.
Continúa con la etapa relacionada y conserva comandos, versiones, métricas y responsables.
Abrir el siguiente paso →Empieza con el equipo disponible y compara GPU o memoria coherente cuando la carga medida lo exija.
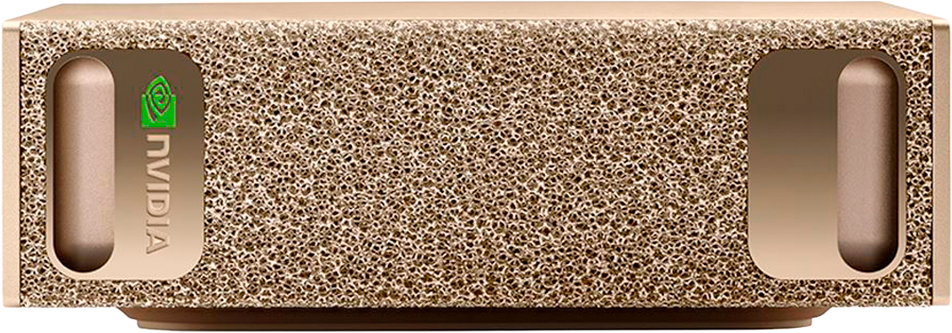
Referencia NVIDIA con 128 GB coherentes para modelos y contextos que exceden la VRAM habitual.
Compra entienda ietres
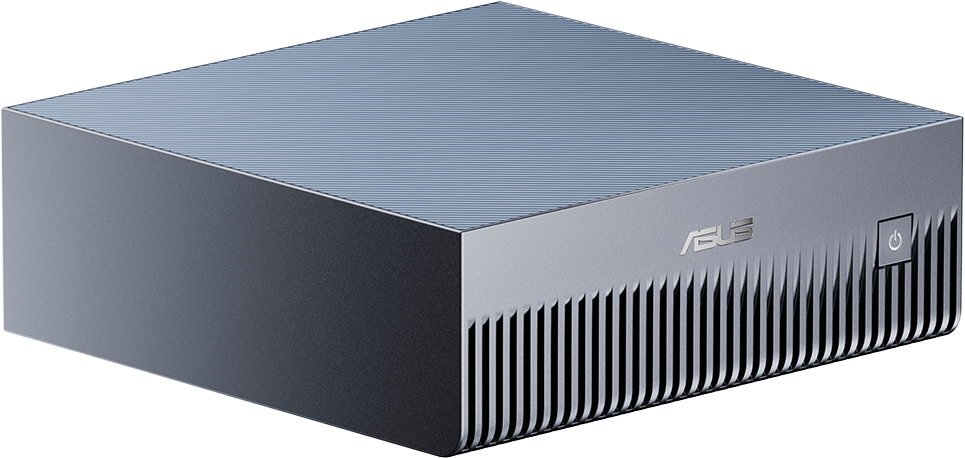
La misma clase de capacidad GB10 con tres escalones de almacenamiento y chasis ASUS.
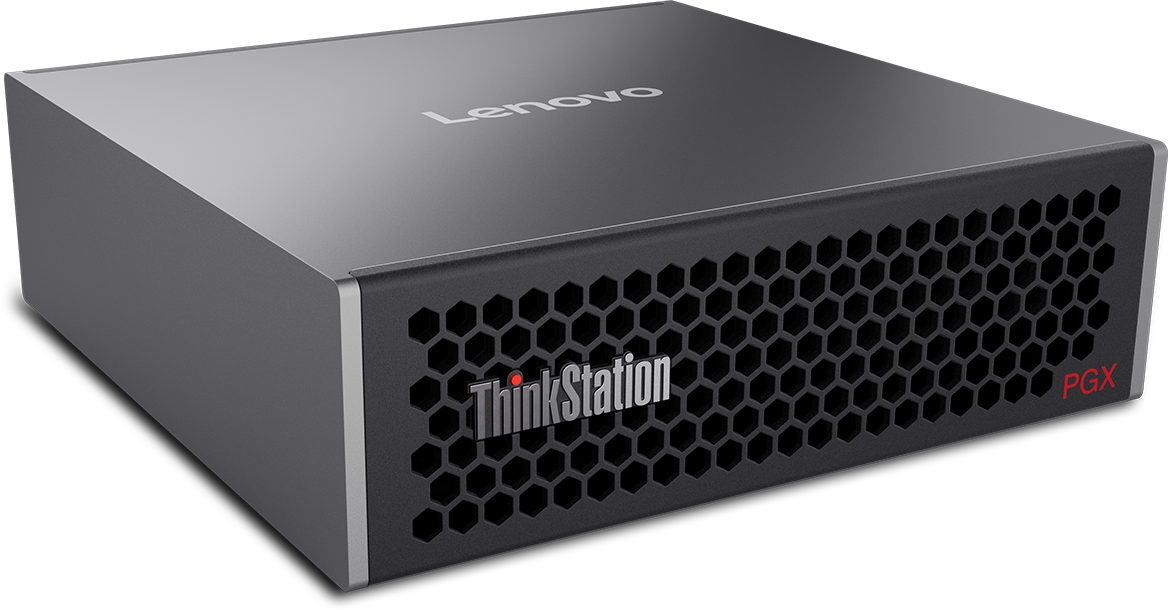
Plataforma GB10 de Lenovo con varias referencias; el almacenamiento es la diferencia principal verificada.
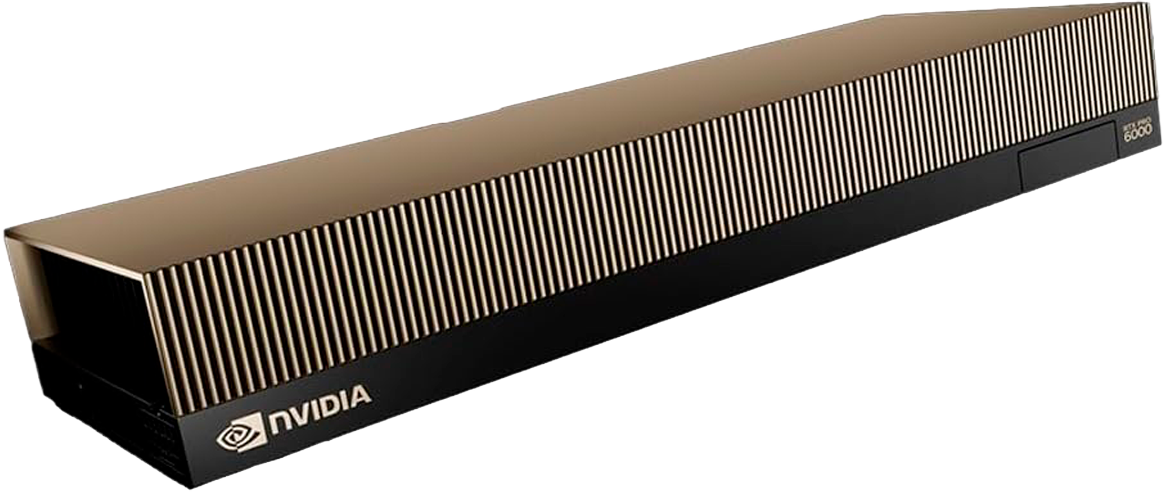
Prioriza velocidad y concurrencia cuando la carga completa cabe en la VRAM disponible.
Compra enietres informática
Ollama es al modelo de IA lo que un reproductor a una película: el programa que lo descarga, lo guarda y lo pone en marcha. Tú escribes una orden (ollama run y el nombre) y él se encarga del resto. Ejemplo real: en un portátil normal, quince minutos después de instalarlo ya estás conversando con un modelo en tu propio equipo, sin cuenta y sin cuota.
Ollama gestiona modelos, plantillas, parámetros y un servicio de inferencia accesible desde línea de comandos o API. Su ventaja es reducir la fricción: descargar una variante, arrancarla y conectarla a una aplicación requiere pocas operaciones.
No es una interfaz empresarial completa ni un sistema de gobierno. Para usuarios, permisos, conversaciones y documentos compartidos se suele añadir Open WebUI. Para automatizaciones se puede integrar con n8n o con código propio.
La aplicación Ollama tiene su propia licencia, mientras que cada modelo conserva la suya. Descargar una variante no concede automáticamente derechos comerciales, de redistribución o de uso sobre determinados datos.
Una vez descargado el modelo, la inferencia puede realizarse en el sistema local. Debes vigilar integraciones, telemetría del resto de herramientas, actualizaciones y accesos de red.
Ollama puede derivar modelos grandes a su servicio cloud. La misma interfaz no significa la misma residencia del dato.
Para un servidor que deba funcionar solo con modelos locales:
OLLAMA_NO_CLOUD=1
También puede utilizarse la opción disable_ollama_cloud en la configuración del servidor. Después hay que reiniciar el servicio y comprobar que las etiquetas utilizadas no sean cloud.
RGPD: ejecutar el modelo localmente facilita el control sobre la transferencia, pero no garantiza el cumplimiento. Finalidad, base jurídica, minimización, retención, seguridad, derechos y evaluación de riesgos siguen siendo necesarios. Consulta la guía para empresas españolas.
| Comando | Uso |
|---|---|
ollama pull <modelo> | Descargar o actualizar una variante |
ollama run <modelo> | Cargar el modelo e iniciar una sesión |
ollama list | Mostrar modelos descargados |
ollama ps | Ver modelos cargados, memoria y procesador |
ollama stop <modelo> | Liberar el modelo cargado |
ollama rm <modelo> | Eliminar una variante local |
ollama show <modelo> | Consultar plantilla, parámetros y metadatos |
Utiliza la biblioteca oficial para elegir una familia y revisar las etiquetas vigentes. En el texto general de esta web se mantienen las familias Qwen, Llama, Gemma, DeepSeek-R1, gpt-oss y Mistral para evitar recomendaciones que caduquen con rapidez.
La "ventana de contexto" es cuánto texto puede tener el modelo delante a la vez: su mesa de lectura. Pedirle que mantenga presente un libro entero exige una mesa enorme, y esa mesa se paga en memoria. Ejemplo: la misma máquina funciona con holgura en conversaciones normales y se queda corta si debe sostener 300 páginas a la vez.
Ollama ajusta valores predeterminados de contexto según la memoria de GPU disponible: sistemas por debajo de 24 GiB parten de 4K, entre 24 y 48 GiB de 32K y a partir de 48 GiB de 256K, de acuerdo con su documentación vigente. Las herramientas de código y agentes pueden necesitar al menos 64K para trabajar con repositorios o historiales amplios.
Un límite alto no implica que debas utilizarlo en todas las solicitudes. La caché KV crece con los tokens, la concurrencia y la arquitectura del modelo. Aumentar contexto puede reducir el número de usuarios simultáneos o provocar descarga a CPU.
ollama ps. Verifica que el modelo sigue usando el acelerador previsto.El servicio local escucha normalmente en 127.0.0.1:11434. Esa dirección limita el acceso al propio equipo. Para que otro contenedor o servidor se conecte puede ser necesario cambiar el enlace, pero publicar 0.0.0.0 sin controles deja el servicio accesible en todas las interfaces.
curl http://127.0.0.1:11434/api/generate -d '{"model":"<modelo-local>","prompt":"Resume este texto","stream":false}'
En una red de empresa, coloca una capa frontal con TLS, autenticación, autorización, límites, tamaño máximo de entrada y registros mínimos. Segmenta el puerto, restringe orígenes y evita acceso directo desde Internet.
Ollama implementa partes de interfaces compatibles con OpenAI y otras integraciones. Valida cada endpoint, campo, streaming, herramientas y formato de error: la compatibilidad no es necesariamente completa.
El mejor escenario es mantener pesos y caché en el acelerador. Si el modelo no cabe, Ollama puede descargar parte del trabajo a CPU, con una reducción de velocidad que depende de memoria, bus y modelo. Esto permite ejecutar algunas cargas mayores, pero no convierte la RAM del sistema en VRAM de igual rendimiento.
Para modelos que caben, una GPU discreta suele ser la opción más rápida. Para modelos y contextos que superan esa VRAM, DGX Spark aporta 128 GB coherentes con CUDA. El recomendador parte de la tarea y del número de usuarios.
No necesitas esta parte para completar el tutorial básico. Ábrela únicamente si vas a administrar el sistema, compartirlo con más personas o resolver una incidencia.
Una instalación útil de Ollama no termina cuando aparece una respuesta en la terminal. Debes saber qué modelo se ha descargado, dónde se guardan sus pesos, qué acelerador utiliza, cuánto contexto consume, qué proceso escucha en la red y qué aplicaciones pueden conectarse. Esta secuencia evita que una prueba personal se convierta en un servicio difícil de mantener.
Descarga el instalador oficial, termina la instalación y abre una terminal nueva para comprobar que el comando está disponible. Ollama se inicia en segundo plano y conserva los modelos en el perfil del usuario.
Descargar OllamaInstala la aplicación en la carpeta de aplicaciones, concédele permiso para exponer el comando y prueba primero un modelo pequeño. La memoria unificada disponible determina el tamaño práctico del modelo y del contexto.
Ver descarga oficialEl instalador configura un servicio. Después conviene revisar su estado, el usuario que lo ejecuta, el acceso al acelerador y los permisos de la carpeta de modelos antes de conectar clientes remotos.
curl -fsSL https://ollama.com/install.sh | sh
systemctl status ollama
Docker facilita versiones y volúmenes reproducibles, pero el contenedor debe recibir acceso explícito a la GPU. Publicar el puerto no añade autenticación: limita la interfaz y coloca un proxy con controles si habrá varios usuarios.
docker run -d --gpus=all \
  -v ollama:/root/.ollama \
  -p 127.0.0.1:11434:11434 \
  --name ollama ollama/ollama
ollama --version y confirma que el servicio responde.ollama ps indica si reside en GPU, CPU o en ambas.127.0.0.1 para uso individual o diseña autenticación, TLS y segmentación para acceso compartido.Resultado esperado: una respuesta correcta no basta. La instalación se considera verificada cuando sabes qué variante responde, dónde se ejecuta, cuánta memoria ocupa y desde qué interfaces puede alcanzarse.
Estos conceptos explican por qué dos equipos con el mismo modelo pueden ofrecer resultados distintos. También evitan una comparación incorrecta entre capacidad máxima, rendimiento interactivo y capacidad multiusuario.
Empieza por la tarea, no por el nombre más conocido. El objetivo es encontrar el modelo más pequeño que alcance la calidad exigida con margen de memoria. Ese margen permite ampliar contexto, mantener el modelo residente y atender más de una petición sin descargar trabajo a CPU.
| Necesidad | Familias que conviene probar | Prueba decisiva | Riesgo habitual |
|---|---|---|---|
| Redacción y resumen en castellano | Qwen, Gemma, Llama y Mistral | Fidelidad al texto, tono y ausencia de datos inventados | Valorar estilo sin comprobar exactitud |
| Razonamiento y análisis | DeepSeek-R1, Qwen y gpt-oss | Problemas propios con respuesta verificable | Confundir una explicación extensa con una respuesta correcta |
| Código | Qwen y variantes orientadas a programación de otras familias | Repositorio real, pruebas automáticas y diff revisable | Medir solo generación de fragmentos aislados |
| Imagen y documentos visuales | Gemma, Llama y Qwen en variantes con visión | Capturas, facturas y diagramas similares a los reales | Usar una etiqueta sin entrada de imagen |
| RAG y búsqueda interna | Un modelo de chat más un modelo de embeddings | Recuperación correcta, citas y rechazo cuando falta evidencia | Atribuir al modelo de chat un problema de recuperación |
| Agentes con herramientas | Familias con tool calling validado por tu orquestador | Esquemas, argumentos, rechazo y recuperación ante error | Dar permisos de escritura antes de probar en modo lectura |
La página Modelos de IA local desarrolla el método de dimensionamiento y evaluación sin fijar una recomendación que caduque cuando cambien las etiquetas.
Si prefieres una interfaz de escritorio para comparar variantes antes de convertirlas en servicio, consulta la guía de LM Studio. Ollama encaja mejor como programa que ejecuta el modelo y API automatizable; LM Studio facilita la exploración visual. La elección depende del flujo, no de una superioridad universal.
ollama list
ollama ps
ollama show <modelo>
list muestra lo descargado, ps la memoria y el procesador mientras el modelo está residente, y show ayuda a revisar plantilla y parámetros.
ollama pull <modelo>
ollama cp <origen> <alias>
ollama stop <modelo>
ollama rm <modelo>
Utiliza alias internos para fijar una configuración validada y evita borrar una variante mientras una aplicación todavía depende de ella.
Un Modelfile permite fijar un modelo base, instrucciones y parámetros. No entrena de nuevo los pesos: crea una configuración reproducible que puede versionarse junto al proyecto.
FROM <familia-y-variante-validada>
PARAMETER temperature 0.2
PARAMETER num_ctx 16384
SYSTEM """
Eres un asistente interno. Responde solo con la información aportada.
Cuando falte evidencia, indícalo y solicita la fuente necesaria.
"""
ollama create asistente-interno -f Modelfile
ollama run asistente-interno
No guardes secretos en el Modelfile. Las instrucciones pueden inspeccionarse y no sustituyen la autorización de la aplicación. Las credenciales, permisos y filtros de datos deben vivir fuera del prompt.
| Parámetro | Qué modifica | Cómo validarlo |
|---|---|---|
temperature | Variabilidad de la generación | Menor para extracción y clasificación; compara repetibilidad y calidad |
num_ctx | Ventana de contexto solicitada | Vigila caché KV, descarga a CPU y concurrencia |
num_predict | Límite aproximado de salida | Evita respuestas innecesariamente largas y costes de latencia |
keep_alive | Tiempo que el modelo queda residente | Equilibra primera respuesta rápida y memoria disponible para otros modelos |
format | Texto, JSON o esquema estructurado en la API | Valida siempre el resultado en la aplicación aunque se solicite un esquema |
Las variables se aplican al proceso que ejecuta el servidor. En Linux suelen configurarse mediante una ampliación de systemd; en macOS mediante el entorno de la aplicación, y en Windows desde las variables de usuario o sistema. Después de cualquier cambio, reinicia Ollama y verifica los registros.
| Variable | Finalidad | Precaución |
|---|---|---|
OLLAMA_NO_CLOUD=1 | Desactiva modelos y funciones que dependen de la nube | Comprueba el registro tras reiniciar y evita etiquetas cloud |
OLLAMA_HOST | Cambia la dirección y el puerto de escucha | 0.0.0.0 expone todas las interfaces; no añade autenticación |
OLLAMA_MODELS | Mueve la carpeta de modelos | El usuario del servicio necesita lectura y escritura; verifica espacio y copias |
OLLAMA_CONTEXT_LENGTH | Fija un contexto predeterminado | Un valor alto reduce el margen de memoria y puede limitar concurrencia |
OLLAMA_KEEP_ALIVE | Controla cuánto tiempo quedan cargados los modelos | Más residencia mejora la primera respuesta, pero retiene memoria |
OLLAMA_MAX_LOADED_MODELS | Limita modelos cargados simultáneamente | No garantiza que todos quepan; prueba el conjunto real |
OLLAMA_NUM_PARALLEL | Ajusta peticiones paralelas por modelo | Aumenta memoria de contexto; mide latencia y errores bajo carga |
OLLAMA_ORIGINS | Autoriza orígenes web adicionales | Permite solo los orígenes necesarios; CORS no sustituye autenticación |
sudo systemctl edit ollama.service

[Service]
Environment="OLLAMA_NO_CLOUD=1"
Environment="OLLAMA_HOST=127.0.0.1:11434"
Environment="OLLAMA_CONTEXT_LENGTH=16384"
sudo systemctl daemon-reload
sudo systemctl restart ollama
systemctl status ollama
La API nativa permite generar texto, conversar, crear embeddings y consultar modelos. Las respuestas finales incluyen tiempos y contadores útiles para separar carga, prefill y generación. Guarda estas métricas junto a la variante y al contexto para que una comparación sea reproducible.
curl http://127.0.0.1:11434/api/chat \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<modelo-local>",
    "stream": false,
    "messages": [
      {"role": "system", "content": "Responde de forma precisa."},
      {"role": "user", "content": "Resume los riesgos indicados."}
    ]
  }'
curl http://127.0.0.1:11434/api/generate \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<modelo-local>",
    "stream": false,
    "prompt": "Clasifica la incidencia",
    "format": {
      "type": "object",
      "properties": {
        "categoria": {"type": "string"},
        "prioridad": {"type": "string"},
        "requiere_revision": {"type": "boolean"}
      },
      "required": ["categoria", "prioridad", "requiere_revision"]
    }
  }'
curl http://127.0.0.1:11434/api/embed \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<modelo-de-embeddings>",
    "input": ["política de devoluciones", "procedimiento de garantía"]
  }'
Compatibilidad OpenAI: Ollama implementa partes de interfaces compatibles en /v1/. Configurar una URL base facilita migrar clientes, pero debes verificar endpoints, herramientas, streaming, errores y formatos. No presupongas equivalencia completa.
Indica si el modelo estaba residente o tuvo que cargarse. Separa este tiempo de la inferencia para no interpretar mal la primera petición.
Divide los tokens de entrada por el tiempo de evaluación del prompt. Es decisivo en RAG, código y documentos largos.
Divide tokens de salida por el tiempo de evaluación de salida. Registra también longitud, calidad y motivo de parada.
| Síntoma | Comprobación | Acción |
|---|---|---|
| El comando no existe | Abre una terminal nueva y revisa el PATH | Repara la instalación o el enlace del binario |
| La API no responde | Comprueba proceso, puerto y registro del servicio | Reinicia y verifica que otra aplicación no ocupa el puerto |
| La respuesta es muy lenta | Ejecuta ollama ps y observa CPU/GPU | Reduce tamaño, contexto o cuantización; libera memoria |
| El modelo se descarga a CPU | Revisa memoria usada por pesos y caché KV | Reduce contexto, cierra otros modelos o elige una variante menor |
| Un contenedor no llega a Ollama | Revisa redes y la dirección de escucha | Utiliza una red interna; no publiques el puerto directamente a Internet |
| Las respuestas cambian demasiado | Fija modelo, prompt y parámetros | Reduce temperatura y crea una batería de evaluación |
| Falta espacio en disco | Ejecuta ollama list y revisa la carpeta de modelos | Retira variantes no usadas o mueve el repositorio con permisos correctos |
| La aplicación recibe JSON inválido | Registra respuesta sin procesar y esquema | Solicita formato estructurado y valida de nuevo antes de usarlo |
Una GPU discreta suele generar más rápido cuando modelo, caché y procesos auxiliares caben en su VRAM. DGX Spark adquiere sentido cuando esa capacidad se agota y necesitas 128 GB coherentes con CUDA. RTX PRO 6000 es una opción de alto rendimiento cuando la carga completa cabe en 96 GB de VRAM. La decisión se toma con modelo, contexto y concurrencia medidos.
Empieza con una variante pequeña, mide calidad y confirma si el límite real es memoria, velocidad o integración. No compres capacidad antes de saber qué carga vas a sostener.
Comprobar el encaje128 GB coherentesPara modelos, contexto y flujos CUDA que superan la VRAM habitual de una sola GPU, manteniendo un formato de sobremesa.
Ver ficha y precio cerrado96 GB GDDR7Para inferencia, imagen, vídeo y servicio con alta velocidad cuando la carga completa cabe en la VRAM disponible.
Abrir la ficha profesionalLa primera comprobación no es solo obtener una respuesta: confirma la variante, el procesador, el contexto, la licencia y que el endpoint no está expuesto más allá de lo necesario.
Seguir la instalaciónLas especificaciones, funciones y límites descritos se contrastan con documentación primaria de Ollama y modelos. Las recomendaciones de compra, el orden de los pasos y los márgenes de planificación son criterios editoriales de AI Supercomputers: deben confirmarse con la versión instalada y una prueba real.
Documentación oficial de Ollama · Biblioteca oficial de modelos · Contexto y comprobación de offload
Sí, si utilizas modelos locales y desactivas las funciones de nube. Ollama también admite modelos en su nube, por lo que no debe asumirse que toda etiqueta se ejecuta localmente.
Configura OLLAMA_NO_CLOUD=1 o disable_ollama_cloud en el archivo de servidor y reinicia Ollama. Esto deshabilita modelos cloud y funciones que dependen de la nube.
Por defecto, Ollama utiliza 127.0.0.1:11434. Ampliar el enlace a la red requiere segmentación, autenticación mediante una capa frontal y reglas de cortafuegos.
Implementa partes de APIs compatibles para facilitar integraciones, pero no debe considerarse una sustitución completa de todas las funciones y comportamientos.
Utiliza ollama ps mientras el modelo está cargado. Comprueba el procesador, la memoria y el reparto entre GPU y CPU.
No debe asumirse. Ollama distribuye y ejecuta modelos con licencias diferentes. Revisa la licencia de cada familia y variante antes de usarla en producción.